Jev od TypeSafe: co to jest i jak używać modelu, który tylko decyduje
Jev nie pisze tekstu, tylko wybiera, ocenia i odpowiada „tak” lub „nie” z podaną pewnością. Gdzie wygrywa z LLM, gdzie zawodzi i jak go wpiąć w aplikację.
Jev to model sztucznej inteligencji amerykańskiej firmy TypeSafe AI, który nie pisze tekstu, tylko podejmuje decyzje. Dajesz mu treść (zgłoszenie klienta, komentarz, rekord z bazy) i pytanie z zamkniętą listą odpowiedzi, a on wybiera jedną opcję, ocenia treść na skali albo odpowiada „tak” lub „nie”, zawsze podając prawdopodobieństwo. Przydaje się tam, gdzie aplikacja pyta dziś duży model językowy o krótką etykietę: przy przydzielaniu zgłoszeń, moderowaniu treści, filtrowaniu spamu czy nadzorowaniu agentów.
TypeSafe przedstawiło Jev 15 września 2026 roku. Cena to 0,042 USD za milion tokenów wejścia, a za wyjście nie płacisz nic. Vercel podał, że w pierwszej dobie po udostępnieniu w AI Gateway z Jev skorzystało ponad dwa razy więcej płacących zespołów niż z jakiegokolwiek wcześniejszego modelu w tym samym czasie, a pod koniec tej doby używało go prawie 13 procent z nich. To dwa razy więcej niż cała rodzina GPT-5.6 i ponad sześć razy więcej niż Claude Fable 5.1.
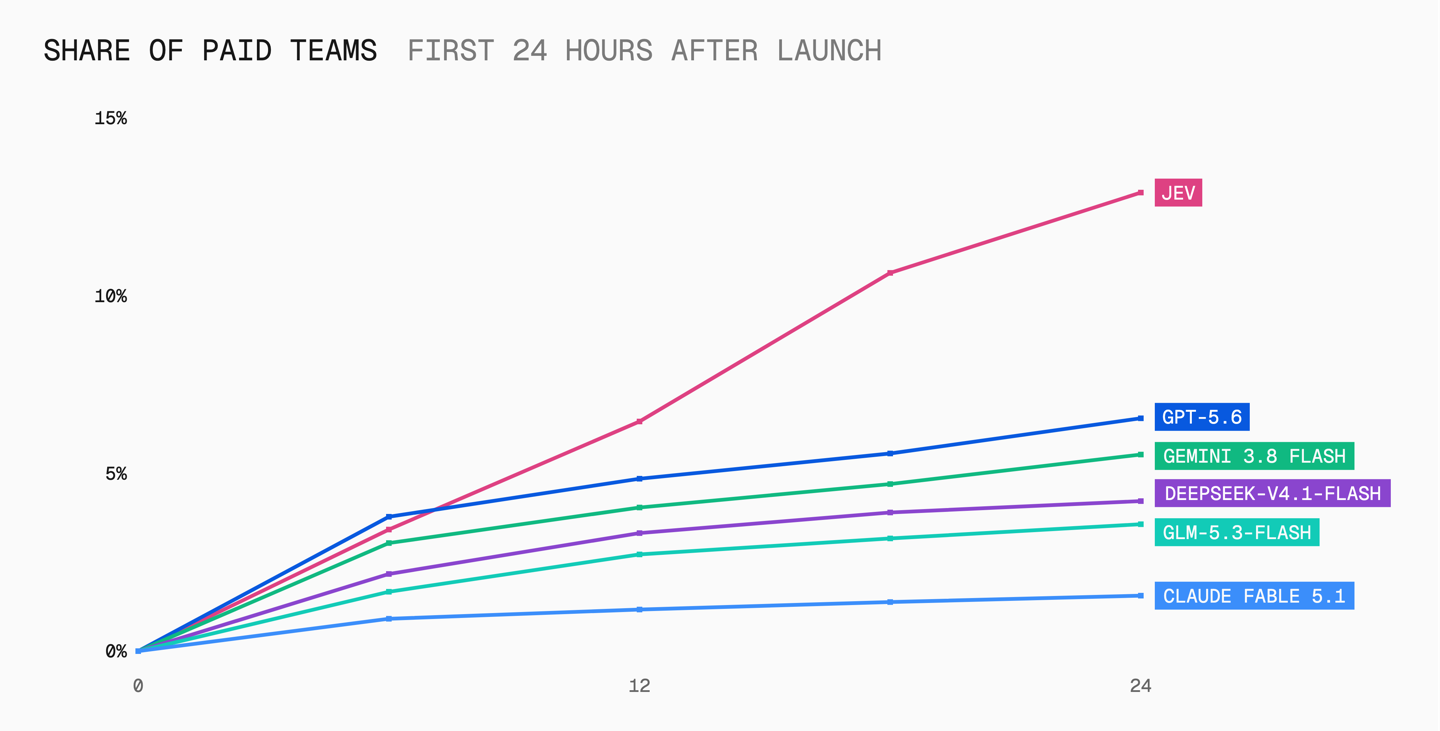
Na wykresie Vercela Jev (różowa linia) wyprzedza porównywane modele przed upływem dwunastu godzin. Vercel udostępnia go jednak za darmo do 25 września i sam zaznacza, że prawdziwym testem będzie to, czy zainteresowanie się utrzyma.
Z dostępem jest zamieszanie. 20 września TypeSafe udostępniło Jev wszystkim, bez listy oczekujących, a 22 września wstrzymało rejestrację nowych kont z powodu ogromnego popytu. Konta założone wcześniej działają normalnie. Bez konta w TypeSafe Jev jest dostępny przez Vercel AI Gateway, OpenRouter i Cloudflare Workers AI.
Czym Jev różni się od modelu językowego
Model językowy, taki jak GPT czy Claude, generuje odpowiedź token po tokenie, więc napisze wszystko: odpowiedź na czacie, kod, streszczenie. Kiedy jednak aplikacja potrzebuje jednego słowa („zwrot”, „spam”, „pilne”), musisz poprosić model o konkretny format i sprawdzić, czy się go trzymał.
Jev działa inaczej. TypeSafe opisuje go jako wywołanie funkcji z inteligencją czołowego modelu: na wejściu nieuporządkowana treść, na wyjściu typowane decyzje z prawdopodobieństwami. Możliwe odpowiedzi definiujesz z góry, a model wylicza wszystkie wyniki równolegle, w jednym zapytaniu. Firma twierdzi, że na takich zadaniach Jev dorównuje modelom językowym, będąc o dwa rzędy wielkości szybszym i wydajniejszym. Szczegółów architektury nie opisuje.
Nazwa klasy modeli, System One, nawiązuje do szybkiego, intuicyjnego „Systemu 1” z książki Daniela Kahnemana „Pułapki myślenia. O myśleniu szybkim i wolnym”, a imię Jev do ekonomisty Williama Stanleya Jevonsa: tak jak wydajniejsze maszyny parowe zwiększyły kiedyś popyt na węgiel, tańsza inteligencja ma zwiększyć popyt na AI. Współzałożycielem firmy jest Diogo Almeida, który według strony zespołu współtworzył metody RLHF i InstructGPT, czyli fundamenty ChatGPT. RLHF nagradza odpowiedzi, które podobają się ludziom. Nowa metoda treningu Jev, RLCD, nagradza prawdopodobieństwa zgodne z tym, jak często model ma rację.
Jedno zastrzeżenie: Jev nie zastąpi modelu w Claude Code, Cursorze czy Codeksie, co dokumentacja TypeSafe mówi wprost. Nie pisze kodu i nie wywołuje narzędzi. Twój agent kodujący ma go wpiąć w aplikację, którą budujesz.
Co naprawdę znaczy „nie halucynuje”
TypeSafe pisze, że Jev nie może halucynować. To prawda w wąskim sensie: jeśli dasz mu listę trzech działów, nie odpowie czwartym i nie zwróci zepsutego JSON-a. Firma sama precyzuje w FAQ, że Jev gwarantuje kształt odpowiedzi, a nie jej poprawność: może wybrać złą kategorię z listy.
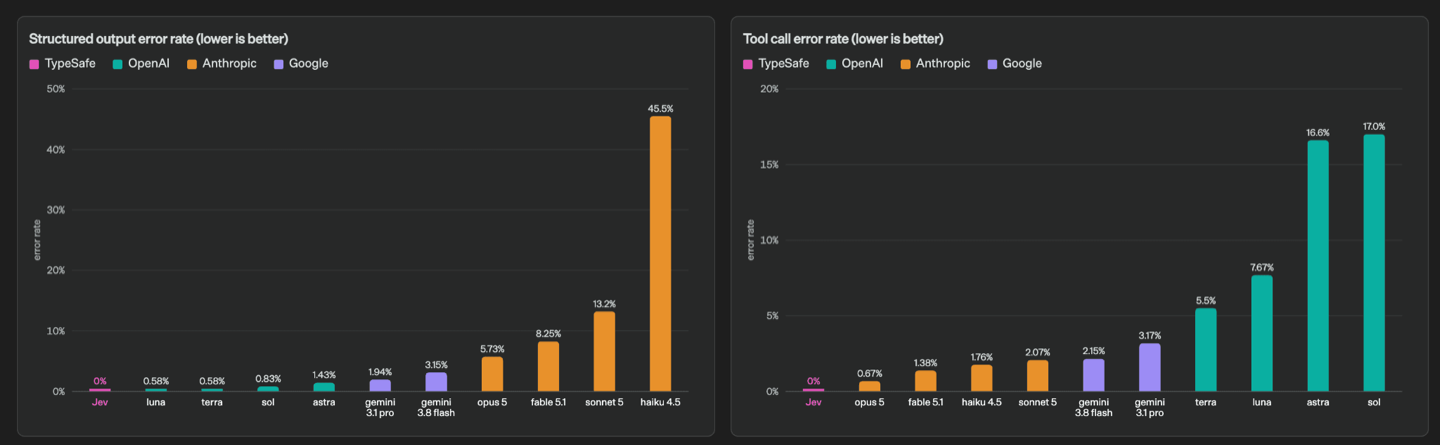
Wykres z wpisu premierowego pokazuje odsetek odpowiedzi w nieprawidłowym formacie i błędnych wywołań narzędzi. Liczby modeli językowych pochodzą z OpenRoutera, a wartość zero przy Jev wynika z konstrukcji modelu, nie z pomiaru. To wykres o formacie, nie o trafności decyzji.
Zamiast obietnicy braku halucynacji dostajesz kalibrację: odpowiedzi z prawdopodobieństwem 0,8 powinny być trafne mniej więcej w 80 procentach przypadków. Dokumentacja zastrzega, że to cecha dużych grup odpowiedzi, a nie gwarancja dla pojedynczej. Odpowiedzialność spoczywa więc na Tobie: ustawiasz próg, powyżej którego aplikacja działa sama, i ścieżkę dla przypadków niepewnych.
Trzy typy pytań
Każde zapytanie ma trzy pola: state (treść do oceny, tekst albo JSON), model i questions, czyli mapę nazwanych pytań. Odpowiedź wraca pod nazwą pytania, a typ określasz w polu type, zawsze małymi literami.
Choice, czyli wybór jednej opcji. Przykład z dokumentacji: klient sklepu z butami dostał zły rozmiar i chce wymiany. Pytanie brzmi „który zespół powinien się tym zająć?”, a opcje to zwroty, wysyłka i płatności.
{
  "state": "My running shoes arrived in the wrong size. Can I swap them for a size 10?",
  "model": "jev-latest",
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which team should handle this?",
      "criteria": {
        "returns": "Exchanges, wrong or damaged items",
        "shipping": "Delivery status, delays, lost packages",
        "billing": "Charges, invoices, payment problems"
      }
    }
  }
}
Odpowiedź wygląda tak:
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "returns",
      "confidence": 1.0,
      "probabilities": { "shipping": 0.0, "returns": 1.0, "billing": 0.0 }
    }
  },
  "usage": { "input_tokens": 328, "output_tokens": 34 }
}
W polu choice jest zwycięska opcja, w probabilities rozkład po wszystkich opcjach, a confidence to pewność od 0 do 1. Możesz zdefiniować do 255 opcji. Dodaj też opcję w rodzaju „inne”, żeby model miał co wybrać, gdy nic nie pasuje.
Score, czyli ocena na skali. Poziomy podajesz jako uporządkowaną listę opisów, od dwóch do dziesięciu poziomów. Przykład: przycisk eksportu powoduje awarię strony ustawień w Safari, w Chrome działa, ale część klientów używa tylko Safari. Na skali „kosmetyka, awaria z obejściem, blokada” Jev zwraca score 1,43 (0,57 dla środkowego poziomu, 0,43 dla najwyższego) i pewność 0,35. Tak wygląda uczciwy sygnał przypadku granicznego.
Noul, czyli pytanie „tak czy nie”. Zwraca jedną liczbę: prawdopodobieństwo odpowiedzi „tak”. Wartości bliskie 0 oznaczają pewne „nie”, bliskie 1 pewne „tak”, a okolice 0,5 niepewność, więc osobne pole pewności nie jest potrzebne. Dokumentacja pokazuje to na pytaniu, czy klient prosi o rozmowę z człowiekiem (wiadomości przetłumaczyliśmy, model dostał je po angielsku):
| Wiadomość klienta | noul |
|---|---|
| „Dzięki, to pomogło!” | 0,02 |
| „Jak zresetować hasło?” | 0,07 |
| „Muszę to mieć załatwione dziś, za wszelką cenę.” | 0,26 |
| „Jesteś botem?” | 0,40 |
| „Czy mogę z kimś porozmawiać o fakturze?” | 0,84 |
| „Pytam już trzeci raz. Mogę po prostu porozmawiać z człowiekiem?” | 0,99 |
Środek tabeli to przypadki, dla których sam musisz ustalić granicę.
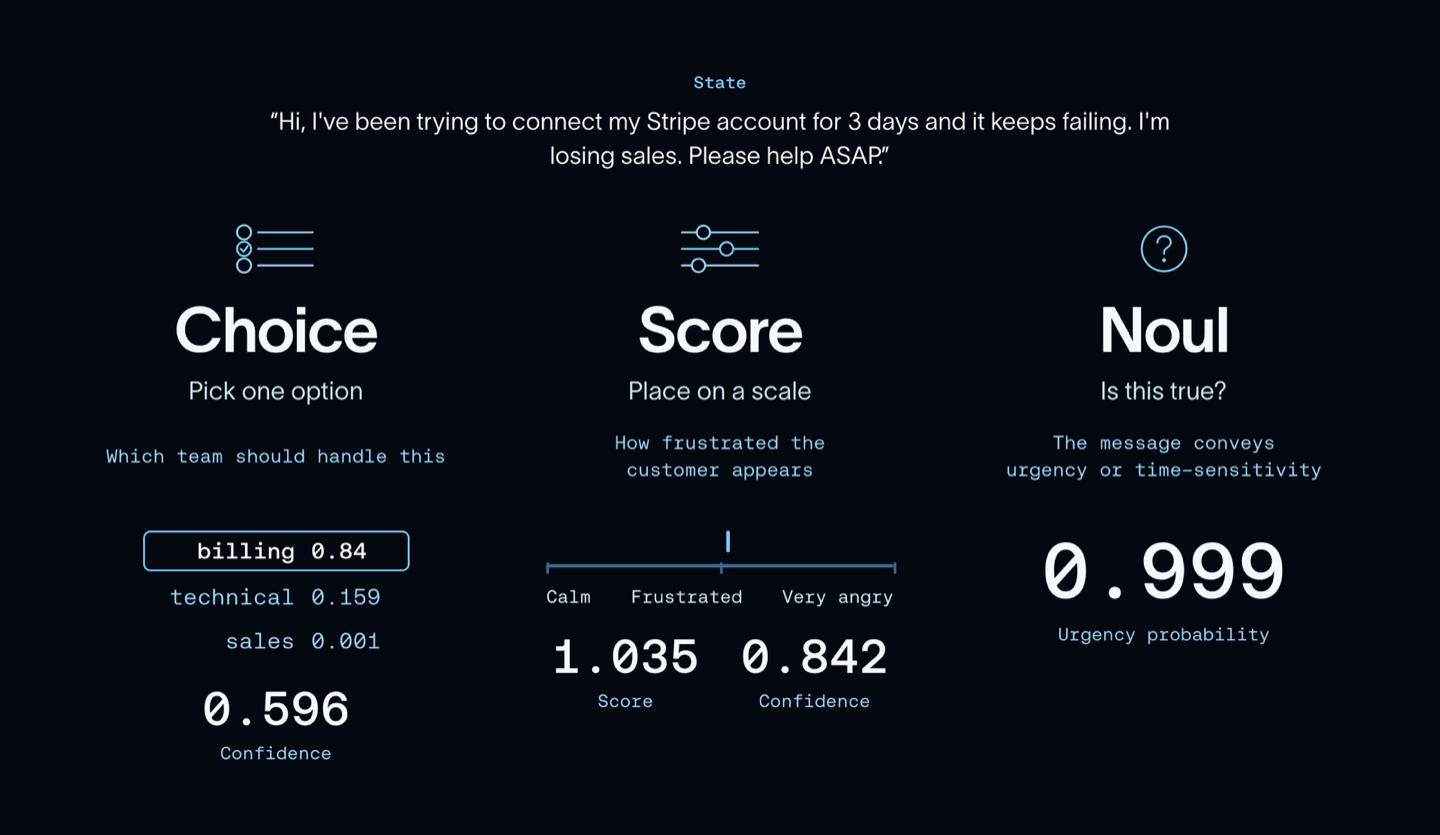
Grafika z bloga LangChain pokazuje trzy typy pytań na przykładzie jednej wiadomości. W lewej kolumnie najwyższe prawdopodobieństwo wynosi 0,84, a pewność tylko 0,596, bo pewność podsumowuje kształt całego rozkładu.
Najważniejsza zasada praktyczna: wszystkie pytania o tę samą treść zadawaj w jednym zapytaniu. Jev ocenia je równolegle i niezależnie, a za treść płacisz raz. W przykładzie z dokumentacji wysłanie 13 pytań o artykuł o RODO w jednym zapytaniu okazało się 12,2 raza tańsze i 10 razy szybsze niż wysyłanie ich osobno, przy tych samych odpowiedziach.
Ile kosztuje Jev i jak szybki jest naprawdę
Cennik jest prosty: 0,042 USD za milion tokenów wejścia, czyli 42 USD za miliard, a tokeny wyjścia są darmowe. Ta sama stawka obowiązuje na OpenRouterze.
Przykład: 100 tysięcy zgłoszeń po około 400 tokenów razem z pytaniami to 40 milionów tokenów, czyli 1,68 USD. Na GPT-6 Luna (0,10 USD za milion tokenów wejścia i 0,50 USD za milion wyjścia) samo wejście kosztuje 4 USD, a jeśli model odpisze na każde zgłoszenie krótkim JSON-em ze stu tokenów, dojdzie około 5 USD. Różnica jest więc kilkukrotna, nie kilkusetkrotna. Wielkie mnożniki z materiałów TypeSafe pojawiają się dopiero przy drogich modelach, które długo rozumują przed odpowiedzią.
Firma zapewnia, że przy tych stawkach zarabia, choć we wpisie premierowym przyznaje, że nie potrafi udowodnić braku dotacji. Jev nie wchodzi w żaden abonament w rodzaju ChatGPT Plus czy Claude Pro. Na koncie TypeSafe płacisz kredytami kupowanymi z góry, które według umowy wygasają po 12 miesiącach i nie podlegają zwrotowi.
Limity: zapytanie może zawierać do 64 tysięcy tokenów, ale treść z najdłuższym pytaniem nie może przekroczyć 32 tysięcy, a na OpenRouterze i w Cloudflare okno kontekstu to 32 tysiące tokenów. Limit zapytań konta TypeSafe wynosi 250 tysięcy tokenów na sekundę i 1200 zapytań na minutę, choć firma zmienia go na bieżąco. Jev przyjmuje wyłącznie tekst.
TypeSafe podaje czas odpowiedzi od 70 do 500 ms, ale mierzy go, wysyłając zapytania z laptopów na zachodnim wybrzeżu USA, gdzie działa usługa. Z Polski doliczysz przelot przez Atlantyk. Niezależny tester, który wykonał około 16 tysięcy zapytań, notował medianę od 0,8 do 0,9 sekundy: nadal szybko, ale to setki milisekund, a nie dziesiątki.
Czy Jev naprawdę pokonał GPT-5.6?
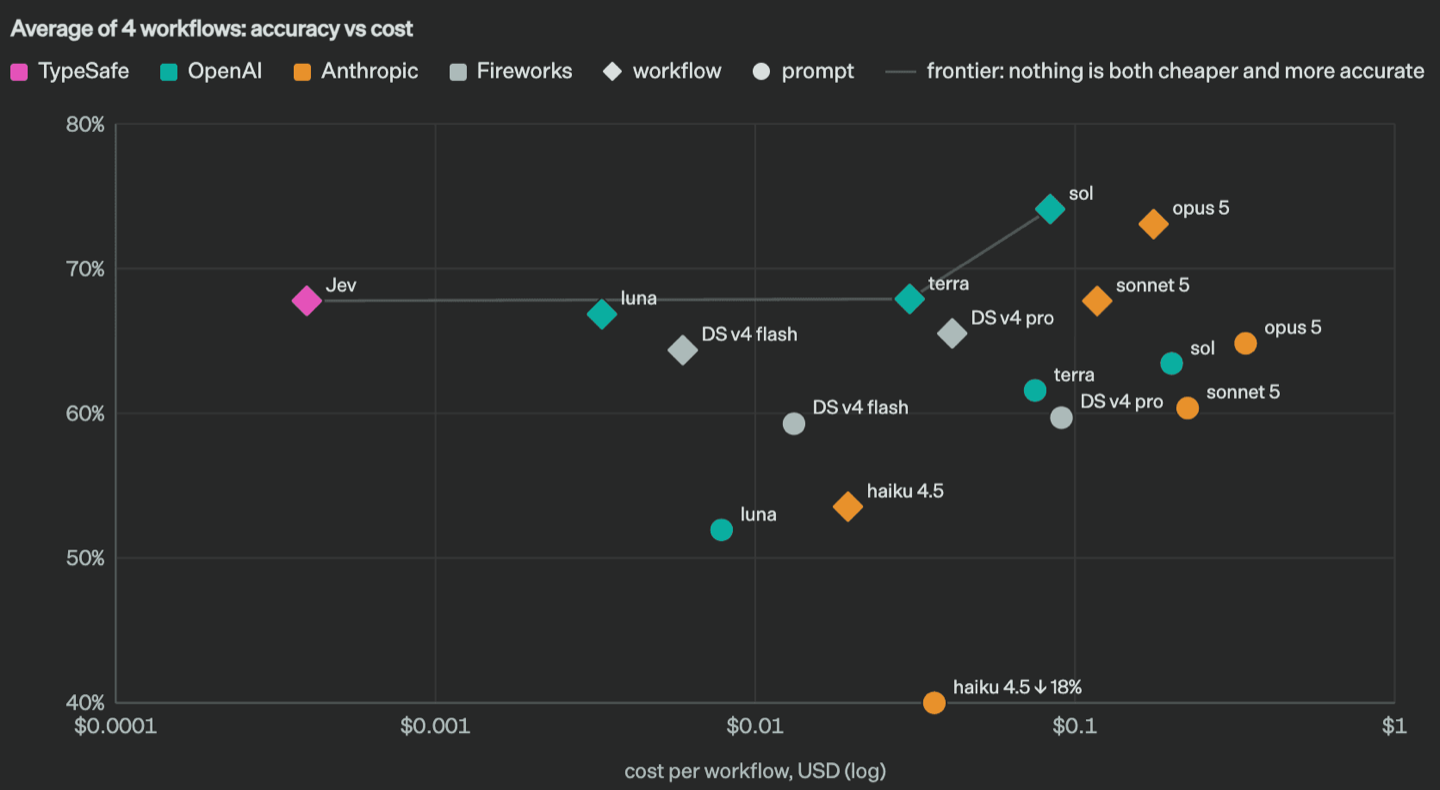
Hasło „193,6 raza szybciej, 444,6 raza taniej” pochodzi z testów samego TypeSafe, które firma uważa za górną granicę realnych zysków. Obejmują cztery scenariusze: incydenty bezpieczeństwa, nadzór nad pracą agenta, obsługę faktur i obsługę klienta. Punktem odniesienia nie są prawdziwe etykiety, tylko uśrednione odpowiedzi GPT-6 Astra i Claude Fable 5.1, co według samej firmy faworyzuje modele OpenAI i Anthropic. Publicznych benchmarków TypeSafe celowo nie publikuje.
| Model | Trafność (średnia z 4 scenariuszy) | Koszt scenariusza | Czas |
|---|---|---|---|
| Jev | 67,8% | 0,0004 USD | 0,4 s |
| GPT-5.6 Luna | 66,8% | 0,0033 USD | 12,9 s |
| GPT-5.6 Terra | 67,9% | 0,0304 USD | 10,1 s |
| Claude Sonnet 5 | 67,8% | 0,1174 USD | 78,1 s |
| Claude Opus 5 | 73,1% | 0,1761 USD | 37,8 s |
| GPT-5.6 Sol | 74,1% | 0,0836 USD | 23,3 s |
Uczciwe podsumowanie: remis z Terrą i Sonnetem 5, minimalnie lepiej od Luny, wyraźnie gorzej od Sola i Opusa 5, przy koszcie 76 razy niższym niż Terra i ponad 8 razy niższym niż Luna. Rozrzut między zadaniami jest duży: w obsłudze klienta Jev osiąga 76,0 procent trafności i wyprzedza Terrę oraz Lunę, a w obsłudze faktur tylko 61,8 procent wobec 79,1 procent Sola. Faktury wymagają czytania całego dokumentu z zależnościami i to wychodzi mu najsłabiej. Okładka poradnika to wykres z tego testu.
Niezależny test na publicznych zbiorach danych (po 300 przykładów) daje podobny obraz. Jev wygrał z GPT-5.6 Luna w wykrywaniu spamu (98,7 wobec 98,0 procent), ocenie wydźwięku recenzji (95,7 wobec 93,0) i kategoryzacji wiadomości (91,3 wobec 89,7), a przegrał w rozpoznawaniu intencji klientów banku z 77 opcjami (76,0 wobec 81,7). Kosztował od 5 do 56 razy mniej niż porównywane małe modele OpenAI. Trafność pewnych odpowiedzi wynosiła od 90 do 100 procent, środek skali był rzutem monetą, a wniosek autora brzmi: filtr, nie zamiennik.
Do czego używać Jev
Dobre zastosowania łączą trzy cechy: zamkniętą listę odpowiedzi, dużą liczbę decyzji i pomyłki, które da się wyłapać progiem albo tanio naprawić.
| Zastosowanie | Pytanie i typ | Co robi aplikacja |
|---|---|---|
| Przydział zgłoszeń | Choice: który dział | Przypisuje zgłoszenie, niepewne kieruje do ręcznej weryfikacji |
| Prośba o rozmowę z człowiekiem | Noul: czy klient chce konsultanta | Przekazuje czat konsultantowi |
| Spam w formularzu | Noul: czy to spam | Pewny spam odrzuca, środek odkłada |
| Moderacja opinii | Noul: wulgaryzmy, dane osobowe, reklama | Publikuje, wstrzymuje albo odrzuca |
| Zabezpieczenie czatu z LLM | Noul: próba obejścia zabezpieczeń; Score: skala szkody | Blokuje albo kieruje do przeglądu |
| Wybór modelu | Choice: zadanie proste czy trudne | Proste wysyła do taniego modelu, trudne do drogiego |
| Kontrola agenta | Noul: czy agent powinien zrobić kolejny krok | Zatrzymuje pętlę albo prosi o zgodę |
| Filtr kontekstu w RAG | Noul: czy fragment odpowiada na pytanie | Przepuszcza tylko trafne fragmenty |
Vercel używa Jev jako domyślnego modelu do oceniania w eve, swoim frameworku dla agentów, o którym pisaliśmy przy okazji Vercel Ship 2026. Jeśli interesuje Cię sam filtr treści, porównaj to podejście z Shieldstralem od Mistrala.
Jak zacząć krok po kroku
Krok 1: sprawdź Jev bez kodu
Playground w konsoli TypeSafe pozwala wkleić tekst, dodać pytanie i od razu zobaczyć prawdopodobieństwa, ale wymaga konta. Bez konta zajrzyj do Jev Lab na OpenRouterze, gdzie w przeglądarce uruchomisz gotowe demonstracje, na przykład triaż zgłoszeń i nadzór nad agentem.
Krok 2: pierwsze wywołanie przez OpenRouter
OpenRouter nie wymaga konta w TypeSafe, wystarczy klucz API (jak go uzyskać, opisujemy w poradniku o OpenRouterze). Jev ma tam identyfikator typesafe/jev-1.13, a zapytania wysyłasz na osobny adres, nie na zwykły czat. To wywołanie zadaje jednocześnie trzy pytania o tę samą wiadomość:
curl https://openrouter.ai/api/alpha/decisions \
  -H "Authorization: Bearer $OPENROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "typesafe/jev-1.13",
    "state": {
      "message": "My running shoes arrived in the wrong size. Can I swap them for a size 10?"
    },
    "questions": {
      "department": {
        "type": "choice",
        "instructions": "Which team should handle this?",
        "criteria": {
          "returns": "Exchanges, wrong or damaged items",
          "shipping": "Delivery status, delays, lost packages",
          "billing": "Charges, invoices, payment problems",
          "other": "Anything else"
        }
      },
      "frustration": {
        "type": "score",
        "instructions": "How frustrated is the customer?",
        "criteria": ["Calm", "Frustrated", "Very angry"]
      },
      "wants_human": {
        "type": "noul",
        "instructions": "Is the customer asking for a human agent?"
      }
    }
  }'
Klucz przechowuj po stronie serwera, nigdy w kodzie przeglądarki. Pole usage.cost w odpowiedzi podaje koszt w dolarach.
Krok 3: oficjalne SDK, także przez Vercel
TypeSafe ma SDK dla JavaScriptu (npm install @typesafe-ai/sdk, Node.js 20 lub nowszy) i Pythona (pip install typesafe-sdk, Python 3.10 lub nowszy). Vercel AI Gateway obsługuje to SDK po zmianie adresu i klucza, więc z kontem na Vercelu poniższy kod zadziała bez rejestracji w TypeSafe:
import { choice, TypeSafeClient } from "@typesafe-ai/sdk";

// Klucz z Vercel AI Gateway. Z własnym kluczem TypeSafe pomiń obie opcje
// i ustaw zmienną środowiskową TYPESAFE_API_KEY.
const client = new TypeSafeClient({
  apiKey: process.env.AI_GATEWAY_API_KEY,
  baseURL: "https://ai-gateway.vercel.sh/typesafe",
});

const response = await client.systemOne({
  state: "My running shoes arrived in the wrong size. Can I swap them for a size 10?",
  questions: {
    department: choice("Which team should handle this?", {
      returns: "Exchanges, wrong or damaged items",
      shipping: "Delivery status, delays, lost packages",
      billing: "Charges, invoices, payment problems",
      other: "Anything else",
    }),
  },
});

const dzial = response.answers.department;
if (dzial.confidence < 0.8) {
  console.log("Niepewne: do kolejki ręcznej");
} else {
  console.log("Dział:", dzial.choice);
}
W Vercel AI SDK model nazywa się typesafe-ai/jev, a pytanie typu tak lub nie oznacza się jako boolean zamiast noul. Gotowe integracje mają też biblioteki LangChain, Pydantic AI i TanStack AI, a Cloudflare Workers AI udostępnia model jako typesafe/jev.
Krok 4: niech Claude Code napisze integrację
TypeSafe przygotowało skill, który uczy agentów kodujących formatu zapytań i sprawdzonych wzorców. W Claude Code instalujesz go dwoma poleceniami:
claude plugin marketplace add typesafe-ai/skills
claude plugin install typesafe@typesafe-ai
W Codeksie i innych agentach użyjesz polecenia npx skills add typesafe-ai/skills --skill typesafe-ai. Potem wystarczy takie zlecenie:
Użyj skilla TypeSafe. Przejrzyj projekt i znajdź miejsca, w których kod prosi
model językowy o krótką etykietę albo decyzję tak lub nie. Zaproponuj zamianę
na Jev. Wszystkie pytania i progi trzymaj w jednym pliku, a przypadki z niską
pewnością kieruj do kolejki ręcznej. Najpierw pokaż plan, potem pisz kod.
Producent ostrzega, że agenty słabo formułują pytania, dlatego pytania i progi powinny znajdować się w jednym pliku: to część integracji, którą musisz sam przejrzeć. Jeśli dopiero zaczynasz pracę z agentem, zajrzyj do pierwszych kroków w Claude Code.
Jak pracować z Jev bezpiecznie
Progi zależne od ryzyka. W przykładzie z dokumentacji dotyczącym bankowości głosowej poniżej pewności 0,6 każde polecenie trafia do konsultanta. System pokazuje saldo już przy 0,6, bo pomyłka niczego nie psuje, a przelew zatwierdza sam dopiero powyżej 0,85. W przedziale od 0,6 do 0,85 dopytuje użytkownika.
Eskalacja zamiast zgadywania. Niepewne przypadki kieruj do człowieka albo droższego modelu. W przykładzie z dokumentacji TypeSafe, który przypisuje 60 raportów rocznych firm do 75 grup branżowych, próg pewności 0,9 podzielił je na pół: pewna połowa była trafna w 90 procentach, reszta w 40. Pydantic AI ma do eskalacji mechanizm zapasowego modelu, a LangChain oferuje router między tanim i drogim modelem.
Przypinaj wersję. Alias jev-latest przeskakuje na nowe wydania, więc odpowiedzi mogą się zmienić bez Twojej wiedzy. Po dostrojeniu progów wpisz konkretną wersję, dziś jev-1.13.0, i przechodź na nowszą świadomie.
Pisz pytania dosłownie. Jev odpowiada na pytanie, które napisałeś, a nie na to, które miałeś na myśli. Z dokumentacji wynika kilka zasad:
- Jedna cecha na pytanie: ogólne pytanie rozbij na kilka wąskich i połącz wyniki w kodzie.
- Przypadki graniczne w opisach opcji: to, co miałeś na myśli, musi się znaleźć w pytaniu albo w opisie opcji.
- Bez podwójnych zaprzeczeń i bez opisów opcji sprzecznych z pytaniem.
- Tylko potrzebna treść: nadmiar kontekstu obniża trafność.
- Kolejność opcji: według Pydantic AI zmiana kolejności może zmienić wynik.
Dwa osobne pytania nie muszą się też dopełniać. W dokumentacji pytanie „czy klient prosi o zwrot pieniędzy?” uzyskało 0,72, a odwrotne „czy prosi o coś innego niż zwrot?” 0,47, razem 1,19. Nie traktuj więc odpowiedzi „nie” jako 1 minus wartość „tak” z innego pytania. Uważaj też na treści napisane tak, by wpłynąć na model: tekst, który przekonuje do konkretnej klasyfikacji, potrafi przesunąć wynik, więc moderację i strażnika agenta przetestuj na takich przypadkach.
Jak przetestować Jev po polsku
Według TypeSafe głównym językiem treningu jest angielski i w nim trafność jest najwyższa, a inne języki model obsługuje gorzej. Proponujemy taki test:
- Zbierz od 100 do 200 prawdziwych polskich wiadomości ze swojej aplikacji i przy każdej zapisz poprawną odpowiedź.
- Przygotuj pytania po polsku i po angielsku przy tej samej polskiej treści. Wybierz wersję, która wypadnie lepiej.
- Każde zapytanie wyślij trzy razy. TypeSafe obiecuje spójność, a nie identyczne wyniki, więc jeśli ta sama wiadomość skacze o więcej niż 0,1, pytanie jest źle postawione.
- Wyniki pytań noul podziel na pasma: poniżej 0,30 „nie”, powyżej 0,70 „tak”, a środek do człowieka. Policz trafność w każdym paśmie i przesuń granice tam, gdzie błędy są dla Ciebie akceptowalne.
- Te same wiadomości daj modelowi GPT-6 Luna albo innemu tańszemu modelowi, którego już używasz, i porównaj trafność oraz koszt.
- W pytaniach choice zmień kolejność opcji i sprawdź, czy odpowiedzi się nie zmieniają.
Jeśli po polsku Jev wyraźnie przegrywa z Luną, korzystaj tylko z pewnych końców skali.
Kiedy nie używać Jev
- Liczenie i arytmetyka: dokumentacja mówi wprost, że Jev nie jest kalkulatorem. Licz w kodzie.
- Porównywanie dat: Jev czyta daty jak tekst. Niech wyciągnie dzień, miesiąc i rok jako wybór z listy, a porównanie zrób w kodzie.
- Generowanie tekstu: odpowiedź dla klienta, streszczenie czy kod to robota dla modelu językowego.
- Długie dokumenty i wieloetapowe rozumowanie: im dłuższa treść i więcej zależności, tym słabiej, co widać po fakturach.
- Obrazy i dźwięk: Jev przyjmuje tylko tekst.
- Samodzielny agent: Jev nie wybiera kolejnych kroków. Może pilnować agenta, ale nie może nim być.
- Nieodwracalne działania bez progu: przelew czy usunięcie konta zawsze z wysokim progiem i potwierdzeniem człowieka.
Dane, prywatność i UE
W polityce prywatności TypeSafe zobowiązuje się, że nie będzie trenować ani dostrajać modeli na Twoich danych. Problem w tym, że usługa jest hostowana w USA, więc korzystając z niej w Europie, przesyłasz dane za ocean. Umowa powierzenia przetwarzania opiera przekazywanie danych z UE na standardowych klauzulach umownych Komisji Europejskiej, a rezygnację z przechowywania danych TypeSafe oferuje tylko klientom w planie enterprise.
Treści bez danych osobowych możesz wysyłać bez większych obaw. Wiadomości klientów z imionami, adresami czy informacjami o zdrowiu najpierw zanonimizuj albo zadbaj o odpowiednią umowę. Vercel, OpenRouter i Cloudflare to dodatkowi pośrednicy, każdy z własnym regulaminem. Umowa TypeSafe zabrania też destylacji, czyli trenowania modelu na wynikach Jev tak, by go naśladował.
Werdykt redakcji
Jev nie jest mądrzejszym ChatGPT, tylko bardzo tanim i szybkim sędzią do wąskich pytań. Przy krótkiej treści i jasnych opcjach dorównuje małym i średnim modelom językowym za ułamek ich ceny, a na jego prawdopodobieństwach da się sensownie oprzeć progi. Przegrywa tam, gdzie trzeba liczyć, porównywać daty, czytać długie dokumenty albo zrozumieć podchwytliwe sformułowanie. W języku polskim każdą obietnicę producenta trzeba sprawdzić na własnych danych.
Najrozsądniej traktować go jak filtr przed droższym modelem: Jev obsługuje pewne przypadki z obu końców skali, a te ze środka trafiają do modelu językowego albo do człowieka. Jeśli Twoja aplikacja wysyła dziś tysiące pytań o jedną etykietę, warto poświęcić popołudnie na test.
Najczęstsze pytania
Czy Jev działa po polsku?
Przyjmuje tekst w innych językach, ale TypeSafe pisze wprost, że głównym językiem treningu jest angielski i to na nim trafność jest najwyższa. Producent zaleca test na własnych treściach przed wdrożeniem i szczególną uwagę na pewność odpowiedzi. Zbierz od 100 do 200 polskich wiadomości z poprawnymi odpowiedziami, porównaj Jev z tańszym modelem językowym i dopiero wtedy decyduj.
Ile kosztuje Jev?
0,042 USD za milion tokenów wejścia, a tokeny wyjścia są darmowe. Sklasyfikowanie 100 tysięcy wiadomości po 400 tokenów kosztuje 1,68 USD. W Vercel AI Gateway Jev jest bezpłatny do 25 września 2026, a na OpenRouterze obowiązuje ta sama stawka co u TypeSafe.
Czy Jev zastąpi ChatGPT albo Claude w mojej aplikacji?
Nie. Jev nie pisze tekstu, nie prowadzi rozmowy i nie generuje kodu, więc nie zastąpi też modelu w Claude Code czy Cursorze. Zastępuje jeden konkretny krok: moment, w którym aplikacja prosi model językowy o krótką etykietę albo decyzję tak lub nie, a potem odczytuje ją z odpowiedzi.
Jak dostać dostęp do Jev, skoro rejestracje są wstrzymane?
TypeSafe wstrzymało zakładanie nowych kont 22 września 2026, a istniejące konta działają dalej. Bez konta w TypeSafe Jev jest dostępny przez OpenRouter (model typesafe/jev-1.13, wystarczy klucz OpenRouter), Vercel AI Gateway (typesafe-ai/jev) i Cloudflare Workers AI (typesafe/jev).
Czy to prawda, że Jev nie halucynuje?
Tylko w wąskim sensie. Jev zawsze odpowiada jedną z opcji, które zdefiniujesz, więc nie wymyśli kategorii spoza listy ani nie zwróci zepsutego formatu. Może jednak wybrać złą opcję. Dlatego każda odpowiedź ma prawdopodobieństwo, a aplikacja powinna niepewne przypadki kierować do człowieka albo droższego modelu.
Czy mogę wysyłać do Jev dane klientów z UE?
TypeSafe deklaruje, że nie trenuje modeli na danych klientów, ale usługa jest hostowana w USA, a transfery z UE opiera na standardowych klauzulach umownych. Rezygnację z przechowywania danych TypeSafe oferuje tylko w planie enterprise. Dane osobowe przed wysłaniem najlepiej zanonimizować.
Opanuj AI‑coding w 5 minut. W każdy poniedziałek.
Konkretne premiery, analizy cen i jeden trik, który przyspieszy Twoją pracę. Po polsku, bez żargonu, prosto na maila.