Claude Haiku 5.5 i Sonnet 5.5: który wybrać?
Haiku 5.5 kosztuje 0,10/0,50 USD, dziesięć razy mniej niż Haiku 4.5, ale powyżej 100 tys. tokenów drożeje. Sonnet 5.5 za 2/10 USD to nowy środek oferty.
Anthropic dołożył do rodziny Claude 5.5 dwa tańsze modele. Claude Haiku 5.5 (7 października) kosztuje w API 0,10 USD za milion tokenów na wejściu i 0,50 USD na wyjściu, dziesięć razy mniej niż Haiku 4.5 (1 i 5 USD). Ta stawka obowiązuje jednak tylko do 100 tysięcy tokenów w zapytaniu, a po uwzględnieniu nowego sposobu dzielenia tekstu na tokeny Anthropic szacuje realną oszczędność na około 75 procent. Claude Sonnet 5.5 (28 września) to nowy środek oferty: 2 i 10 USD, tyle co Sonnet 5, ale działa ponad 30 procent szybciej i według producenta wykonuje zadania nawet o 30 procent taniej. Krótko: Sonnet 5.5 do codziennego kodowania, Haiku 5.5 do drobnych zadań wykonywanych masowo, a Opus 5.5 do najtrudniejszych zadań. Oba nowe modele działają w aplikacji Claude w każdym planie, także darmowym, a do tego w Claude Code, GitHub Copilot i Cursorze.
Ceny: trzy półki
Do progu 100 tysięcy tokenów Haiku 5.5 kosztuje dwadzieścia razy mniej niż Sonnet 5.5, a Sonnet 5.5 dwa razy mniej niż Opus 5.5 (4 i 20 USD). Odczyt z pamięci podręcznej, czyli cache, z którego agent korzysta przy każdym kroku, kosztuje w Haiku 5.5 jeden cent za milion tokenów. W Sonnecie 5.5 Anthropic obniżył tę stawkę 7 października z 0,20 do 0,10 USD, co według firmy zmniejsza koszt typowej pracy agenta o około 20 procent.
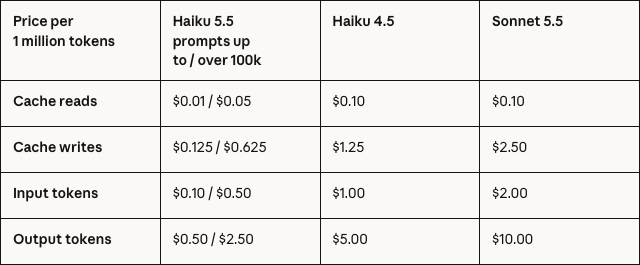
Pierwsza kolumna ma dwie stawki: do 100 tysięcy tokenów w zapytaniu i powyżej tego progu.
Sonnet 5.5: co dostajesz za tę samą cenę
W Terminal-Bench 4.0 Sonnet 5.5 ma według Anthropic 70,6 procent, wobec 10,3 procent Sonneta 5 i 66,4 procent w najlepszym wyniku Opusa 5.5. Producent zastrzega jednak, że przy złożonych, otwartych zadaniach wymagających dłuższego namysłu Opus 5.5 nadal jest wyraźnie mocniejszy. Dla osób budujących aplikacje ciekawy jest test Base44: przy budowie 118 aplikacji Sonnet 5.5 dawał wyniki na poziomie Opusa 5, ale potrzebował średnio 3,6 rundy poprawek zamiast 7,7 i rzadko zatrzymywał się, żeby dopytać użytkownika.
Haczyk: próg 100 tysięcy tokenów
Powyżej 100 tysięcy tokenów stawki Haiku 5.5 są pięć razy wyższe: 0,50 USD na wejściu i 2,50 USD na wyjściu. Do progu wlicza się całe wejście, także kontekst czytany z cache, a droższa stawka obejmuje całe zapytanie. Według Anthropic takie krótsze zapytania to około 90 procent tego, co trafiało do Haiku 4.5, więc w typowej aplikacji próg będzie przekraczany rzadko.
Inaczej jest przy kodowaniu z agentem. Sesja w Claude Code czy Cursorze wysyła przy każdym kroku kod, instrukcje i historię rozmowy, więc łatwo przekracza 100 tysięcy tokenów. Dokumentacja Cursora ostrzega wprost, że długie sesje z dużym kontekstem kosztują wtedy więcej za token. Do tego nowy sposób liczenia tworzy z tego samego tekstu mniej więcej o 30 procent więcej tokenów niż w Haiku 4.5.
Który model do czego
Anthropic sam wyznacza granicę: Haiku 5.5 ma obsługiwać wąsko zdefiniowane zadania, takie jak streszczenia, sortowanie treści do kategorii, skracanie historii rozmowy i praca w roli subagenta, czyli pomocnika, któremu główny agent zleca wycinek roboty. Do złożonego kodowania z agentem lepsze są według producenta Sonnet 5.5 i Opus 5.5.
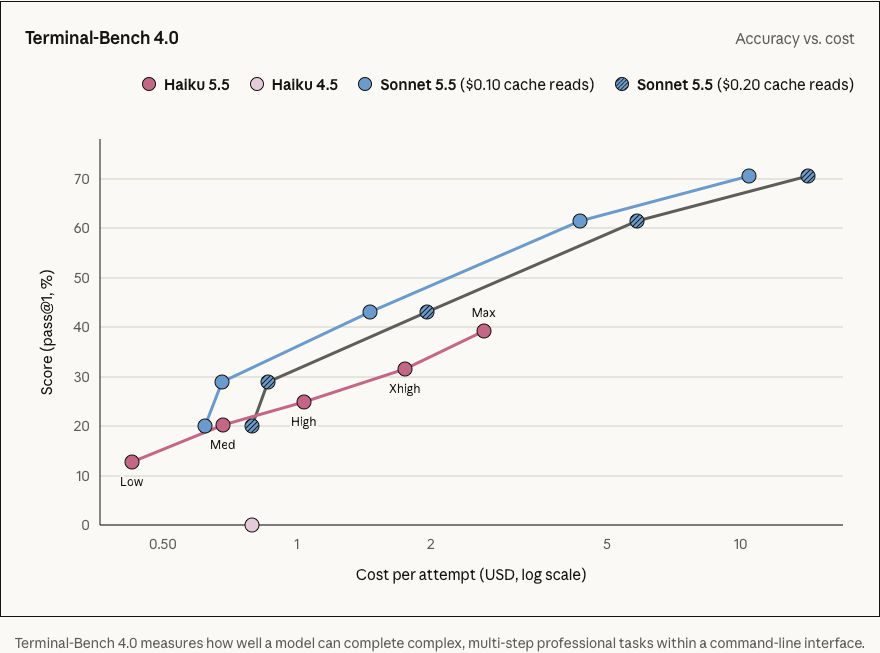
Wykres z ogłoszenia Haiku 5.5 dobrze to pokazuje. W Terminal-Bench 4.0, teście, w którym agent wykonuje zadania programistyczne w terminalu, na średnim nakładzie (effort, czyli ile pracy model wkłada w zadanie) obie próby kosztują po 0,68 USD, ale Haiku 5.5 zdobywa 20,3 procent, a Sonnet 5.5 28,8 procent. Na maksimum Haiku dochodzi do 39,2 procent za 2,64 USD, a Sonnet do 70,6 procent za 10,44 USD. Haiku 4.5 miał w tym teście zero.
Co to oznacza w praktyce:
- Claude Code: model zmienisz komendą
/model. W wersji 2.1.284 Sonnet 5.5 został domyślnym Sonnetem, a w 2.1.293 Haiku 5.5 domyślnym Haikiem w API Anthropic. Haiku warto przypisać własnym subagentom od przeszukiwania kodu i prostych zmian. - Cursor: oba modele dodasz w Cursor Settings, w zakładce Models. To modele zewnętrzne, więc nie są objęte pulą wliczoną w plan, a stawki są takie jak w API. W CursorBench na maksymalnym nakładzie Haiku 5.5 ma 48,4 procent, a Sonnet 5.5 55,5 procent, co daje mu drugie miejsce za Opusem 5.5.
- GitHub Copilot: oba modele są dostępne w planach Pro, Pro+, Max, Business i Enterprise i rozliczane po cenach dostawcy w ramach rozliczenia za zużycie.
- Lovable: wbudowane połączenie z modelami AI dla Twoich aplikacji wymienia na razie z rodzin Sonnet i Haiku tylko Sonnet 5 i Haiku 4.5. Lovable testował już Sonneta 5.5 i odnotował o jedną trzecią mniej wywołań narzędzi na zadanie.
Co z abonentami Pro i Max
Haiku 5.5 wybierzesz w aplikacji Claude w planach Free, Pro, Max, Team i Enterprise, w przeglądarce, na iOS i Androidzie. Sonnet 5.5 jest dostępny dla wszystkich, także bez płatnego planu. W aplikacjach i w Claude Code Sonnet 5.5 pracuje domyślnie na średnim nakładzie.
- Zużycie limitu: według centrum pomocy Anthropic jedna tura w Claude Code kosztuje z Opusem kilka razy więcej niż z Sonnetem, a z Sonnetem więcej niż z Haiku. Rutynowe poprawki na Sonnecie 5.5 albo Haiku 5.5 pozwolą więc zrobić więcej w ramach limitu pięciogodzinnego i tygodniowego.
- Nakład: niski i średni poziom wystarczą do rutynowej pracy i pozwalają najdłużej pracować przed wyczerpaniem limitu. Wyższy daje staranniejsze odpowiedzi, ale zużywa więcej tokenów i szybciej wyczerpuje pulę.
- Kredyty API dla Max i Team: razem z Haiku 5.5 Anthropic wprowadził miesięczne kredyty na budowanie własnych aplikacji: 100 USD w Max 5x, 200 USD w Max 20x i do 500 USD na zespół w Team. Nie obejmują Pro ani Claude Code, a niewykorzystane przepadają z końcem okresu rozliczeniowego.
Własna aplikacja na Haiku 4.5? Nie podmieniaj nazwy w ciemno
Anthropic ostrzega, że kod napisany pod Haiku 4.5 może przestać działać na Haiku 5.5. Parametry temperature, top_p i top_k, ręcznie ustawiany limit tokenów na rozumowanie oraz prefill (początek odpowiedzi podany modelowi do dokończenia) mogą kończyć się błędem 400. W Claude Code przejście przeprowadzi polecenie /claude-api migrate, które podmienia identyfikator modelu i poprawia parametry. Przejście z Sonneta 5 na Sonneta 5.5 też wymaga zmian: żeby wyłączyć myślenie przed odpowiedzią, trzeba wysłać ustawienie between_tools zamiast disabled, a wymuszone wywołanie narzędzia zwraca błąd 400. Haiku 4.5 nadal działa: w tabeli wycofań ma status aktywny i nie ma wyznaczonej daty wyłączenia. Wyznaczono ją za to Sonnetowi 4.5, który zniknie z API 30 listopada 2026, a jego następcą jest Sonnet 5.5.
Co to znaczy dla vibe codingu
Sonnet 5.5 buduje funkcje i poprawia błędy, Opus 5.5 planuje i prowadzi trudne refaktory, a Haiku 5.5 sprawdza się jako pomocnik do powtarzalnej roboty. Jeśli Twoja aplikacja streszcza, klasyfikuje albo odpowiada klientom, Haiku 5.5 obniży rachunek w porównaniu z Haiku 4.5 według Anthropic średnio o około 75 procent, a najwięcej wtedy, gdy zapytania mieszczą się w 100 tysiącach tokenów. Do roli głównego agenta w długich sesjach kodowania lepiej wybrać Sonneta 5.5: przy tym samym koszcie próby robi więcej.
Opanuj AI‑coding w 5 minut. W każdy poniedziałek.
Konkretne premiery, analizy cen i jeden trik, który przyspieszy Twoją pracę. Po polsku, bez żargonu, prosto na maila.