Claude Opus 5.5: 40% taniej niż Opus 5, a limity w abonamencie starczą o 25% dłużej
Claude Opus 5.5 kosztuje w API 4/20 USD, a na Pro, Max i Team limit starcza o ok. 25% dłużej niż z Opusem 5. Do tego wyższe limity i darmowy reset.
Anthropic wydał 22 września Claude Opus 5.5. W API ceny spadają o 20 procent: 4 USD za milion tokenów na wejściu i 20 USD na wyjściu, wobec 5 i 25 USD za Opusa 5. Według Anthropic typowa praca na domyślnych ustawieniach kosztuje dzięki temu o 40 procent mniej, a w większości zadań model wypada na poziomie Fable 5.1, najdroższego modelu firmy. Abonenci Pro, Max i Team też zyskują: limit starcza z nowym modelem o około 25 procent dłużej niż z Opusem 5, limity pięciogodzinne rosną, a do tego dochodzi darmowy reset limitu. Odpowiedzi generuje ponad 30 procent szybciej niż Opus 5.
Skąd 40 procent, skoro ceny spadają o 20
Różnicę robi pamięć podręczna, czyli cache. Kiedy agent pracuje nad projektem, przy każdym kroku wysyła do modelu ten sam kontekst: kod, instrukcje i historię rozmowy. Model czyta go z cache po obniżonej stawce, a ta spada z 0,50 do 0,20 USD, czyli o 60 procent. Według Anthropic takie odczyty to większość kosztów kodowania i pracy agentowej. Drugim źródłem oszczędności jest mniejsze zużycie tokenów na zadanie.
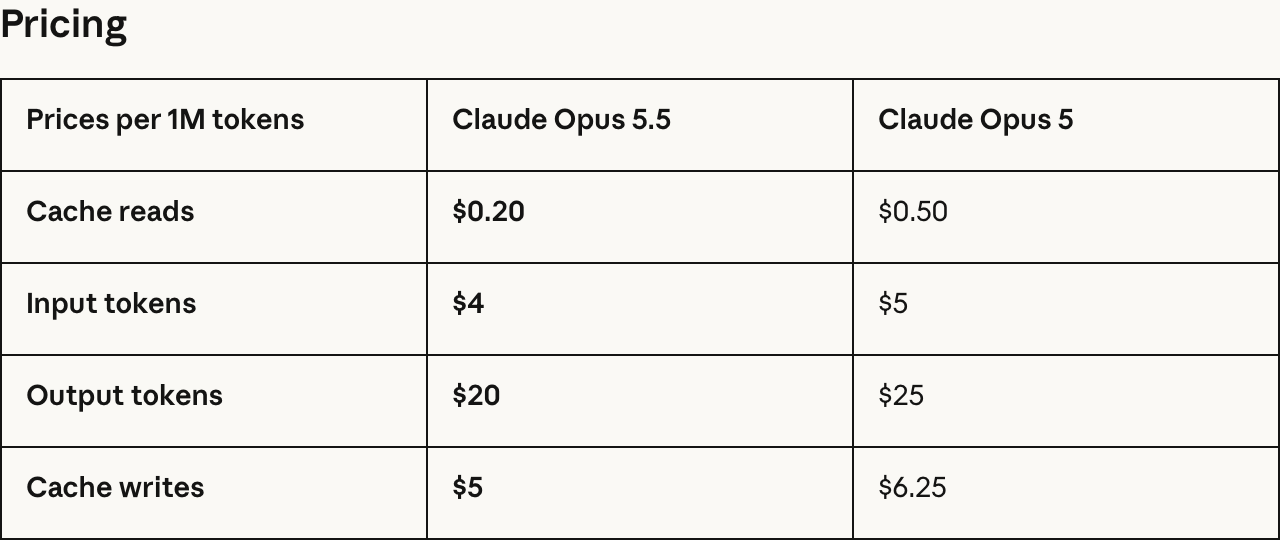
Tanieje każda pozycja cennika, ale najmocniej odczyt z cache, z którego agent korzysta najczęściej.
Niezależny pomiar Artificial Analysis pokazuje haczyk: na maksymalnym nakładzie (effort, czyli ile pracy model wkłada w zadanie) Opus 5.5 prowadzi w jego indeksie inteligencji z 58 punktami, ale zużywa 260 milionów tokenów wyjścia, prawie dwa razy więcej niż Opus 5. Na domyślnym poziomie medium ma 51 punktów, tyle co Opus 5 na maksimum, przy 38 milionach tokenów.
Co dostają abonenci Pro, Max i Team
W aplikacji Claude wybierzesz Opusa 5.5 z menu modelu na każdym płatnym planie (w darmowym planie Opusa nie ma). W Claude Code od wersji 2.1.280 jest modelem domyślnym na Pro, Max, Team i Enterprise. Na Pro i standardowych stanowiskach w Team to spora zmiana, bo dotąd domyślnym modelem był tam Sonnet 5. Na Pro Opus 5.5 mieści się w limitach planu, a Fable 5.1 jest tam dostępny tylko za płatne kredyty.
- Zużycie limitu: na Pro, Max i Team niższa cena przekłada się na limity, także przy kontekście czytanym z cache, więc starczają one o około 25 procent dłużej niż z Opusem 5. Obniżka odczytu z cache o 60 procent dotyczy tylko API.
- Limity pięciogodzinne: rosną w planach Pro, Max i Team oraz w Enterprise rozliczanym za stanowisko. Limit tygodniowy, wspólny dla wszystkich modeli, zostaje osobnym sufitem.
- Nakład: Opus 5.5 zawsze myśli przed odpowiedzią. Wyższy nakład szybciej wyczerpuje limit, a na poziomach low i medium starcza on najdłużej.
- Tryb szybki: w Claude Code działa do 2,5 raza szybciej, ale w abonamencie jest rozliczany wyłącznie z kredytów, poza limitem planu.
Reset limitu: jak go wykorzystać
Subskrybenci płatnych planów dostają po jednym darmowym resecie. Na moim koncie pojawiła się karta „Resets” z przyciskiem „Reset for free”, a reset jest ważny do 22 października. Według centrum pomocy działa tak:
- Gdzie: w ustawieniach, w zakładce Usage, w przeglądarce albo aplikacji desktopowej. Klikasz „Reset for free” w sekcji Resets i potwierdzasz. Ten sam przycisk pojawia się w komunikacie o wyczerpanym limicie.
- Gdzie go nie ma: przycisku nie ma w aplikacji mobilnej ani w Claude Code, ale limity są wspólne, więc pełna pula wraca też w terminalu.
- Co przywraca: od razu odnawia do pełna limit pięciogodzinny albo tygodniowy, zależnie od rodzaju resetu.
- Haczyki: resetu nie cofniesz i nie zmienia on salda kredytów. Przepada, jeśli przed jego użyciem obniżysz plan albo zrezygnujesz z subskrypcji.
Moja rada: nie odpalaj resetu od razu. Zostaw go na dzień, w którym przy większej migracji albo refaktorze uderzysz w limit w połowie roboty.
Benchmarki i dwa przykłady z testów
Według danych Anthropic w Terminal-Bench 4.0 (kodowanie agentowe w terminalu) Opus 5.5 ma 66,4 procent, wobec 52,3 procent Opusa 5 i 57,9 procent GPT-6 Astry. Astra prowadzi za to w AutomationBench i Terminal-Bench-Science.
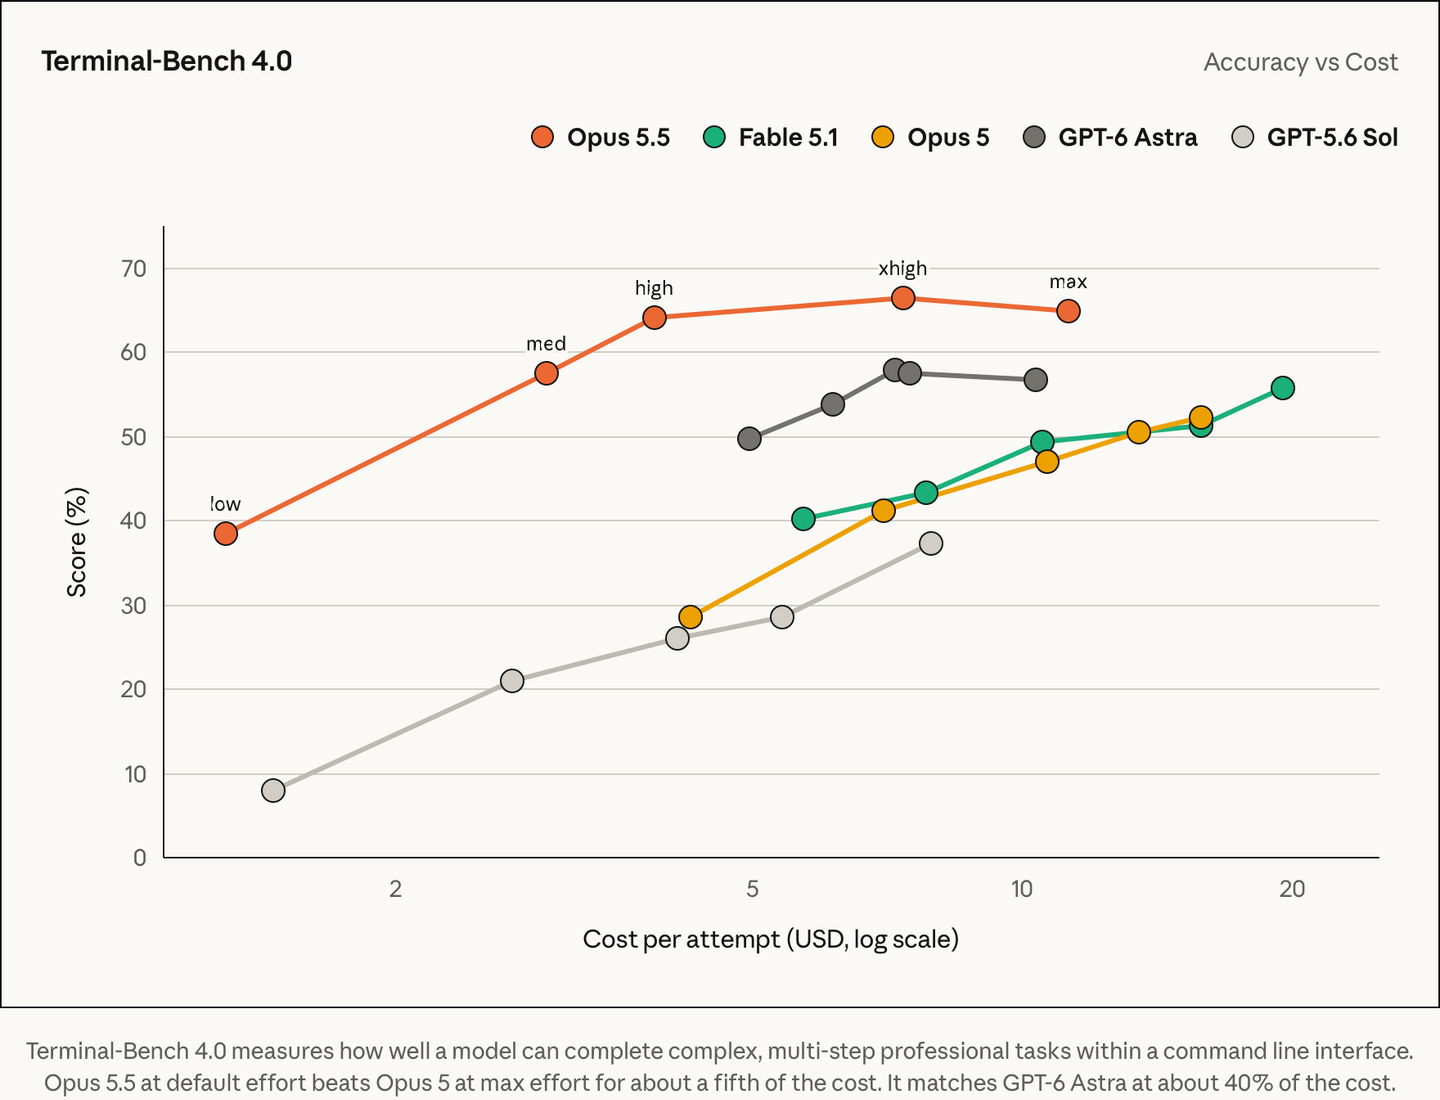
Na domyślnym poziomie medium Opus 5.5 bije Opusa 5 na maksimum za około jedną piątą kosztu próby.
Jeden z testerów przeniósł 680 tysięcy linii kodu w niecały dzień, co według Anthropic zajęłoby zespołowi tygodnie. W teście Anthropic model miał skrócić czas ładowania każdej strony aplikacji webowej. Opus 5.5 osiągnął cel w 39 z 40 prób, a Opus 5 wprowadzał mniejsze poprawki i przy okazji zmieniał zachowanie aplikacji. To klasyczna pułapka pracy z agentem: strona działa szybciej, ale już inaczej.
Pisze prościej, działa ostrożniej
Nowy model daje najważniejsze informacje na początku odpowiedzi i rzadziej sięga po żargon, więc łatwiej sprawdzić, co agent właściwie zrobił. Według Anthropic rzadziej też podejmuje działania trudne do odwrócenia i wychodzi poza wyznaczone granice: w nowym teście próbował je omijać o około 85 procent rzadziej niż Opus 5. Jest też odporniejszy na prompt injection, czyli polecenia ukryte w stronie, pliku albo mailu, które agent bierze za twoje instrukcje. Przy agencie z dostępem do plików i aplikacji to waży więcej niż benchmarki. Własne zabezpieczenia nadal są jednak obowiązkowe: kopia zapasowa, ograniczone uprawnienia i osobne środowisko testowe.
Zadania z cyberbezpieczeństwa trafią do starszego modelu
W biologii i cyberbezpieczeństwie Opus 5.5 dorównuje modelowi Mythos 5.1, czyli odmianie Fable 5.1 z luźniejszymi zabezpieczeniami dla wybranych organizacji, więc dostał zabezpieczenia podobne do Fable 5.1. Model normalnie szuka i poprawia błędy w twoim kodzie, ale większość zadań z cyberbezpieczeństwa trafi do Opusa 4.8.
Co dalej
W API model ma nazwę claude-opus-5-5. W najbliższych tygodniach mają dołączyć Sonnet 5.5 i Haiku 5.5. Tego samego dnia OpenAI wydało GPT-6 Sol i Lunę.
Co to znaczy dla vibe codingu
Przy długich migracjach, refaktorach i wielogodzinnych sesjach agenta Opus 5.5 daje według producenta jakość zbliżoną do Fable 5.1 za 40 procent jego ceny. Zostań przy domyślnym nakładzie medium i podnoś go dopiero wtedy, gdy wynik nie wystarcza. Według centrum pomocy Opus zużywa na jedną turę kilka razy więcej limitu niż Sonnet, więc do rutynowych poprawek przełącz się komendą /model na Sonnet 5.
Opanuj AI‑coding w 5 minut. W każdy poniedziałek.
Konkretne premiery, analizy cen i jeden trik, który przyspieszy Twoją pracę. Po polsku, bez żargonu, prosto na maila.