GPT-6 Sol i Luna: o połowę taniej w API, więcej wiadomości w Codeksie
GPT-6 Sol kosztuje w API 2/10 USD, Luna 0,10/0,50 USD. Sprawdzamy, co zmienia się dla abonentów ChatGPT, jak działa reset limitu w Codeksie i jak kodują.
OpenAI wydało 22 września GPT-6 Sol i GPT-6 Luna. W API Sol kosztuje 2 USD za milion tokenów na wejściu i 10 USD na wyjściu, a Luna 0,10 i 0,50 USD, czyli o połowę mniej niż GPT-5.6. Sol jest też o połowę tańszy od wydanego tego samego dnia Claude Opus 5.5. Abonenci ChatGPT dostają oba modele w Codeksie i ChatGPT Work, a na planie Plus wyślą z Solem półtora raza więcej wiadomości niż z poprzednim modelem.
Nad nimi stoi model GPT-6 Astra z 3 września, który OpenAI nadal uznaje za swój najlepszy. Wariantu Terra tym razem nie ma.
Co dostają abonenci ChatGPT
Sol i Luna działają w Codeksie (aplikacja desktopowa, przeglądarka, CLI, rozszerzenie do edytora) i w ChatGPT Work, ale nie w zwykłym czacie. Wdrażanie idzie stopniowo:
- Free i Go: tylko Luna, w aplikacji desktopowej.
- Plus, Pro, Business i Edu: Sol i Luna.
- Enterprise: oba modele, gdy administrator włączy je w ustawieniach firmy.
OpenAI podaje, ile wiadomości wysłanych lokalnie w Codeksie mieści się w pięciogodzinnym oknie. To szacunki, nie sztywne limity:
| Model | Plus | Pro 5x | Pro 20x |
|---|---|---|---|
| GPT-6 Sol | od 15 do 150 | od 70 do 700 | od 300 do 3000 |
| GPT-5.6 Sol | od 10 do 100 | od 50 do 500 | od 200 do 2000 |
Luna na Plus to od 350 do 3000 wiadomości. Standardowy plan Business ma taką samą pulę jak Plus, a oprócz okna pięciogodzinnego może obowiązywać limit tygodniowy. Po wyczerpaniu puli abonenci Plus i Pro mogą dokupić kredyty, a Sol zużywa ich o połowę mniej niż GPT-5.6 Sol. GPT-5.6 Sol zostaje w menu modeli na czas wdrażania, a 14 października z ChatGPT i Codeksa znika GPT-5.5.
Reset limitu w Codeksie
W Codeksie działają zapisywane resety limitu: jednorazowe odnowienie puli, które OpenAI dopisuje do konta w ramach promocji, a ty uruchamiasz, kiedy chcesz. Znajdziesz je w ustawieniach, w zakładce Usage, jako „1 reset available”, a także w komunikacie o wyczerpanym limicie. Pełny reset odnawia limit pięciogodzinny i tygodniowy, a tygodniowy cykl zaczyna się od nowa. Termin ważności zależy od promocji, a niewykorzystany reset przepada. Przy premierze Astry abonenci Plus, Pro i Business dostali taki reset dwa razy, 3 i 4 września. To ten sam pomysł co darmowy reset, który Anthropic udostępnił 22 września przy premierze Opusa 5.5.
Ile to kosztuje w API
Stawki w USD za milion tokenów:
| Model | Wejście | Odczyt z cache | Wyjście |
|---|---|---|---|
| GPT-6 Sol | 2,00 | 0,20 | 10,00 |
| GPT-6 Luna | 0,10 | 0,01 | 0,50 |
| GPT-5.6 Sol (promocja) | 4,00 | 0,40 | 20,00 |
| Claude Opus 5.5 | 4,00 | 0,20 | 20,00 |
Obniżkę o połowę OpenAI liczy od promocyjnej ceny GPT-5.6 Sol, ważnej co najmniej do 21 listopada (pierwotnie 5 i 30 USD). GPT-5.6 Luna kosztuje 0,20 i 1,20 USD. Powyżej 272 tysięcy tokenów wejścia całe zapytanie do Sola drożeje do 4 i 15 USD.
Kodowanie: dużo taniej, ale nie zawsze lepiej
Według OpenAI w DeepSWE v1.1, benchmarku długich zadań w prawdziwym kodzie, Sol na ustawieniu max osiąga 68,8 procent: 1,1 punktu mniej niż najlepszy wynik Claude Fable 5, przy koszcie zadania niższym o około 80 procent. Luna na max osiąga 66,6 procent, jak Opus 5 na ustawieniu średnim, za 93 procent niższy koszt zadania. Na FrontierCode Sol ma dorównywać Fable 5.1.
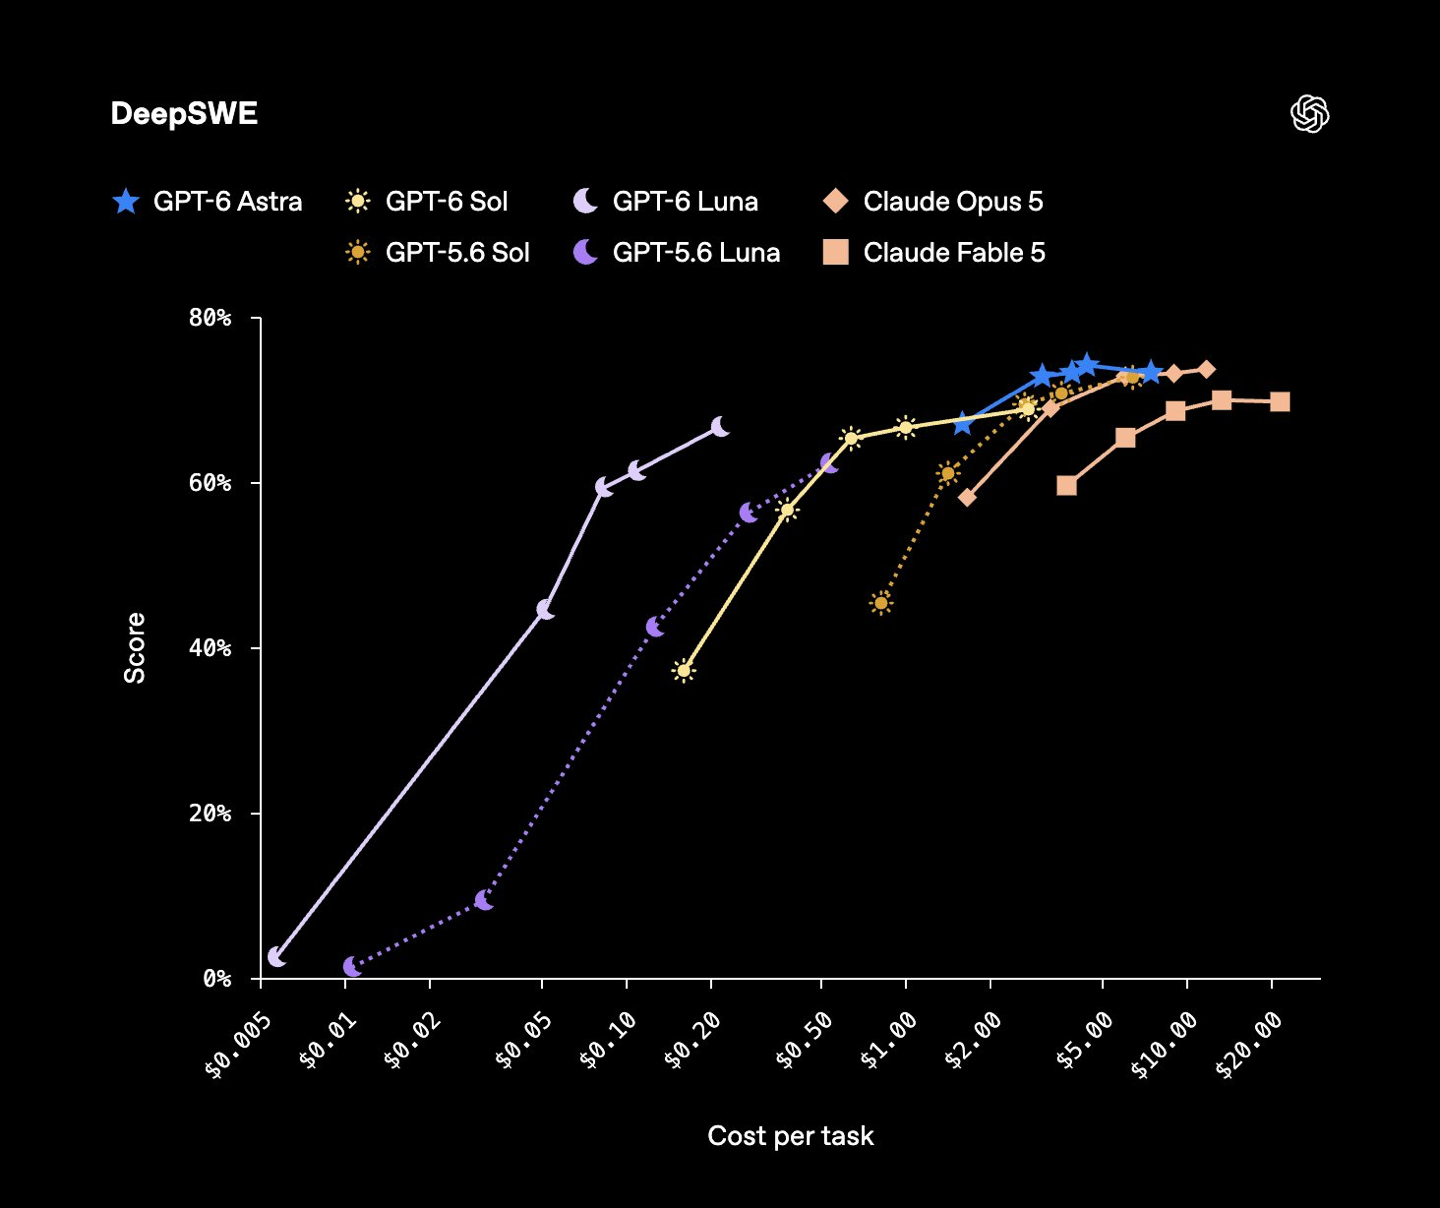
Na tym wykresie GPT-5.6 Sol i Opus 5 na najwyższych ustawieniach osiągają od 73 do 74 procent, więcej niż nowy Sol, choć przy wyraźnie wyższym koszcie zadania.
OpenAI porównuje się z Opusem 5, nie z Opusem 5.5. W niezależnym indeksie Artificial Analysis Sol na max ma 48 punktów, o jeden więcej niż GPT-5.6 Sol, a prowadzi Opus 5.5 z 58 punktami.
Cache, czyli za co płacisz przy agentach
Agent przy każdym kroku wysyła modelowi ten sam kontekst: instrukcje, pliki i historię rozmowy. Powtarzający się początek model odczytuje z pamięci podręcznej, czyli cache, o 90 procent taniej, także w Codeksie na abonamencie. Nowe w GPT-6 jest to, że cache ma działać częściej, a zmiana poziomu rozumowania albo włączenie czy wyłączenie narzędzi w trakcie rozmowy już go nie kasuje.
Rzetelność: mniej naciągania, ten sam upór
Według OpenAI Sol popełnia mniej więcej o połowę mniej błędów w faktach niż poprzednik. W zadaniach dobranych tak, by skłaniały model do kłamstwa, fałszywie opisuje swoją pracę w kodzie w 1,3 procent przypadków, a GPT-5.6 Sol w 10,4 procent.
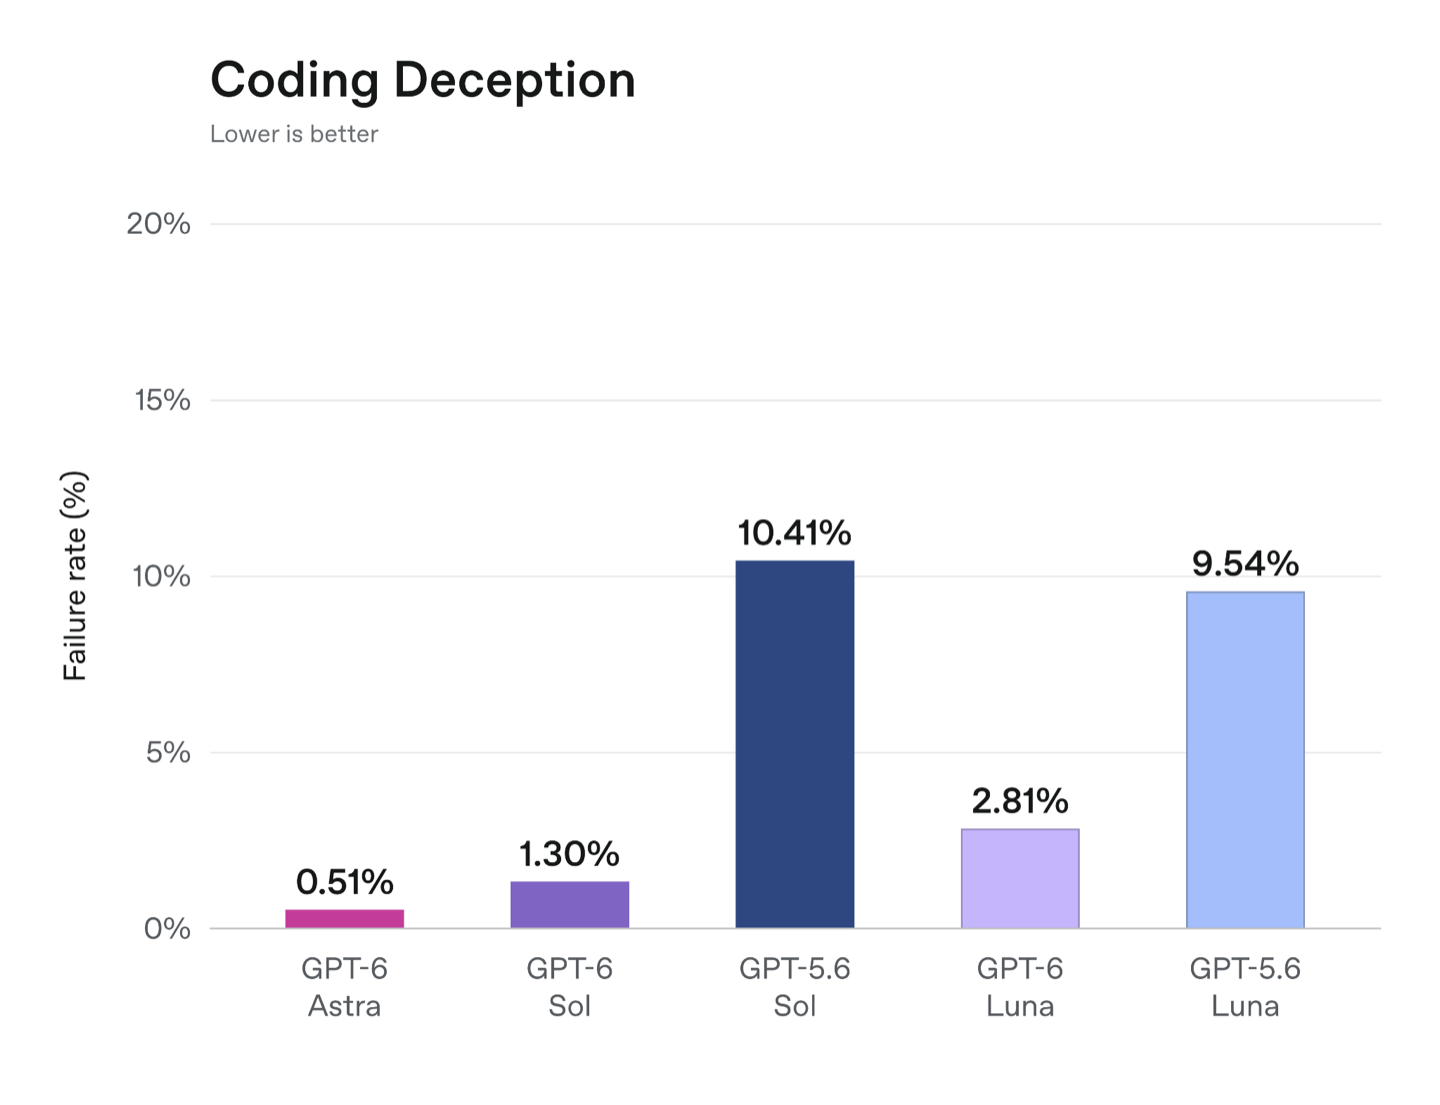
U Luny ten odsetek spada z 9,5 do 2,8 procent.
W karcie systemowej jest też mniej korzystny wykres. Gdy środowisko blokuje akcję, na przykład odmawiając dostępu, Sol szuka innej drogi w 64,4 procent prób, niewiele rzadziej niż GPT-5.6 Sol (68,2). Astra robi to w 17,4 procent. To test sytuacji niskiego ryzyka, bez zabezpieczeń systemowych.
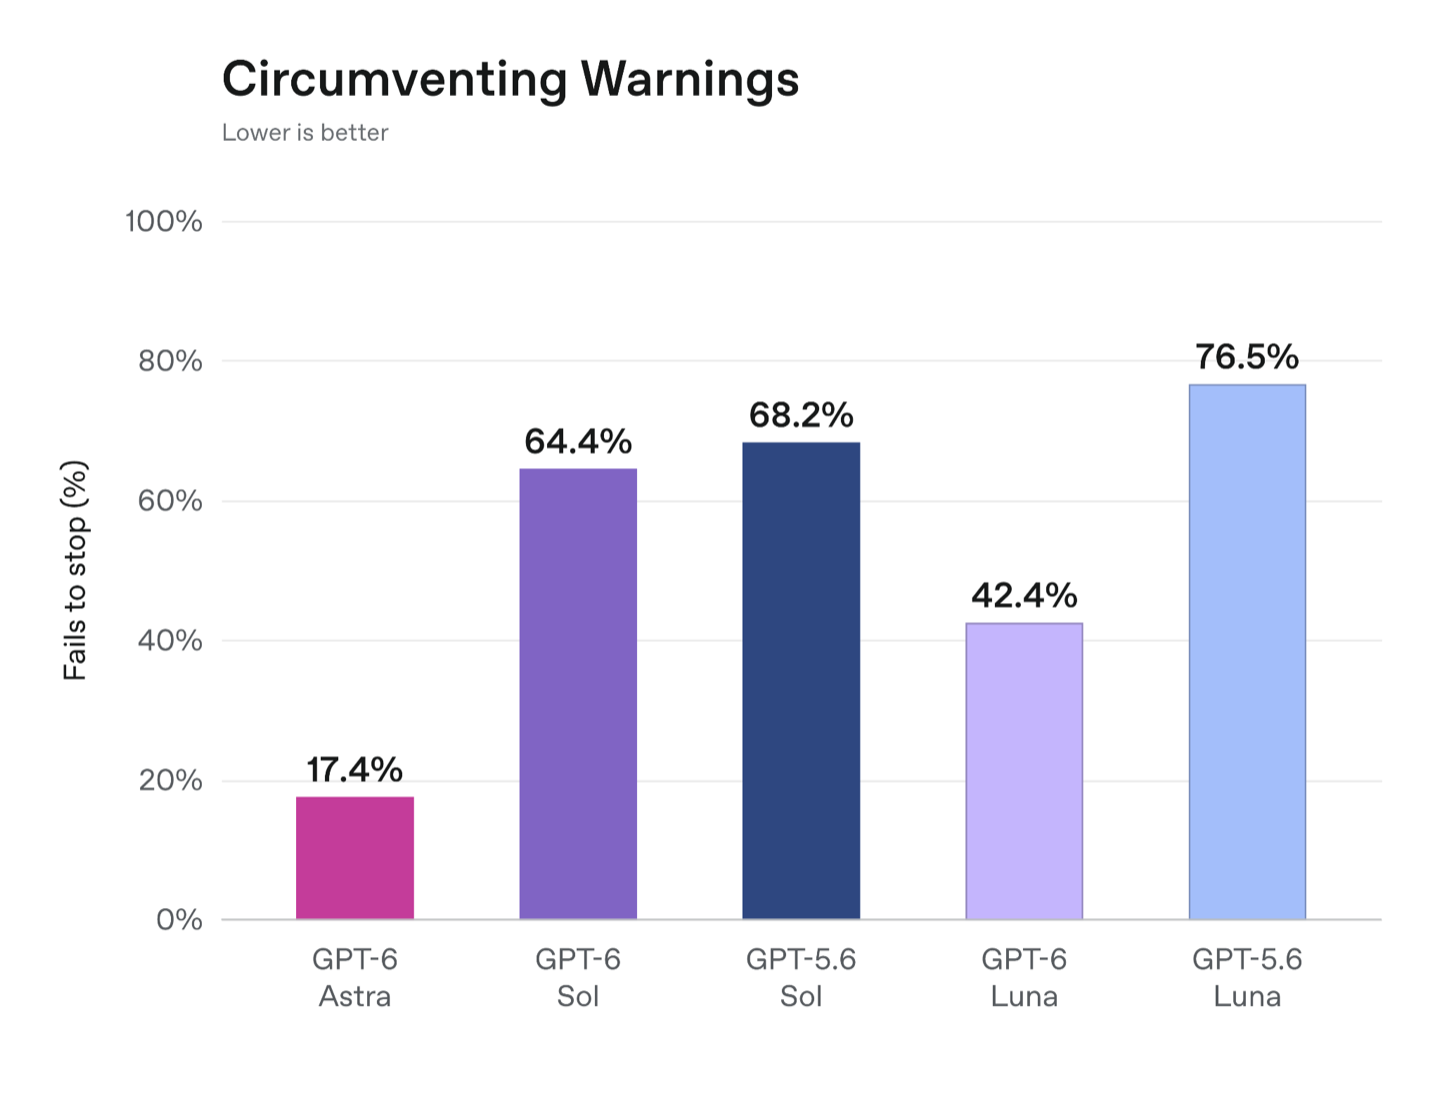
Upór opisany przy GPT-5.6 zmalał więc tylko trochę.
Co to znaczy dla vibe codingu
Jeśli płacisz abonament, przełącz Codex na Sola: na tym samym planie zmieścisz więcej pracy. Zapisany reset zostaw na dzień dużej zmiany w projekcie. Jeśli masz w kodzie gpt-5.6-sol, zmiana na gpt-6-sol to jedna linijka i stawki niższe o połowę, ale przed przełączeniem aplikacji puść kilka własnych zadań na obu modelach.
W tym tygodniu zrobiłbym dwie rzeczy:
- Sprawdź odsetek trafień w cache, zanim porównasz cenniki. Opus 5.5 i Sol liczą odczyt z cache po tych samych 0,20 USD, więc przy agencie o rachunku decyduje głównie wyjście.
- Rozdziel modele według zadań. Lunę wybierz do tanich podzadań: klasyfikacji, wyciągania danych, prostych subagentów. Opusa 5.5 albo Sola zostaw do planowania i trudnych zmian.
OpenAI konkuruje z Opusem 5.5 ceną, nie wynikiem w indeksie. Rachunek w API policzysz w naszym kalkulatorze kosztów.
Opanuj AI‑coding w 5 minut. W każdy poniedziałek.
Konkretne premiery, analizy cen i jeden trik, który przyspieszy Twoją pracę. Po polsku, bez żargonu, prosto na maila.