Prompt caching w GPT-6: jak płacić mniej za API
OpenAI poprawiło cache w GPT-6: powtórzony prompt kosztuje 10% stawki przez 30 minut, ale zapis 125%. Liczymy rachunek i mówimy, co zmienić w aplikacji.
OpenAI opisało 22 września ulepszony prompt caching w modelach GPT-6. Cache, czyli pamięć podręczna, w której model przechowuje powtarzający się początek zapytania, ma być wykorzystywany częściej bez zmian w kodzie i czeka na ponowne użycie 30 minut. Odczyt z cache kosztuje 10 procent zwykłej stawki za wejście, na przykład 0,20 zamiast 2 USD za milion tokenów w GPT-6 Sol. Haczyk: zapis do cache jest o 25 procent droższy od zwykłego wejścia, więc zyskujesz tylko wtedy, gdy ten sam początek wraca. Agenci i długie rozmowy korzystają z tego automatycznie, a aplikacja wysyłająca ten sam prompt z nowym pytaniem potrzebuje jednej poprawki.
Czym jest cache promptu
Agent w Codeksie przy każdym kroku wysyła modelowi te same instrukcje, opisy narzędzi i dotychczasową historię pracy, a na końcu dokłada nowy wynik, na przykład treść pliku albo komunikat błędu. Bez cache model przeliczałby wszystko od zera. Cache zapamiętuje obliczony stan dla niezmienionego początku, więc model liczy tylko to, co nowe. Płacisz mniej za powtórzone tokeny i krócej czekasz na odpowiedź.
Początek musi być identyczny co do znaku, łącznie z ustawieniami. Inny model, zmieniona lista narzędzi albo inny format odpowiedzi kasują trafienie. W GPT-6 buforowany fragment musi mieć co najmniej 1024 tokeny.
Co zmieniło się w GPT-6
Według OpenAI nowy system cache daje więcej trafień od razu, bez dodatkowej konfiguracji. Rabat obejmuje początek użyty ponownie w ciągu 30 minut, a każde użycie odnawia ten czas bez ponownej opłaty za zapis. OpenAI pisze też wprost, że ulepszenia cache i sposobu uruchamiania modeli pozwoliły obniżyć ceny Sola i Luny o połowę względem promocyjnych cen GPT-5.6.
Do tego dochodzą narzędzia dla twórców aplikacji:
- Poziom rozumowania bez utraty cache: w trakcie rozmowy podniesiesz go na czas trudnego zadania albo obniżysz przy rutynowej poprawce (modele GPT-6, tryb jednego agenta).
- Narzędzia bez kasowania cache: zamiast usuwać narzędzie z listy, wyłączasz je dla danego zapytania.
- Punkty podziału: sam wskazujesz, gdzie kończy się część warta zapamiętania.
- Rozgrzewanie: aplikacja przygotowuje instrukcje przy starcie, zanim padnie pierwsze pytanie. Taki zapis kosztuje tyle co zwykły zapis do cache.
- Panel i diagnostyka: panel Prompt Caching pokazuje odsetek trafień w czasie, a bezpłatna diagnostyka podaje przyczynę chybienia, na przykład zmienioną listę narzędzi.
Nowy jest przede wszystkim silnik cache: panel działa od 20 sierpnia, a diagnostyka od 8 września.
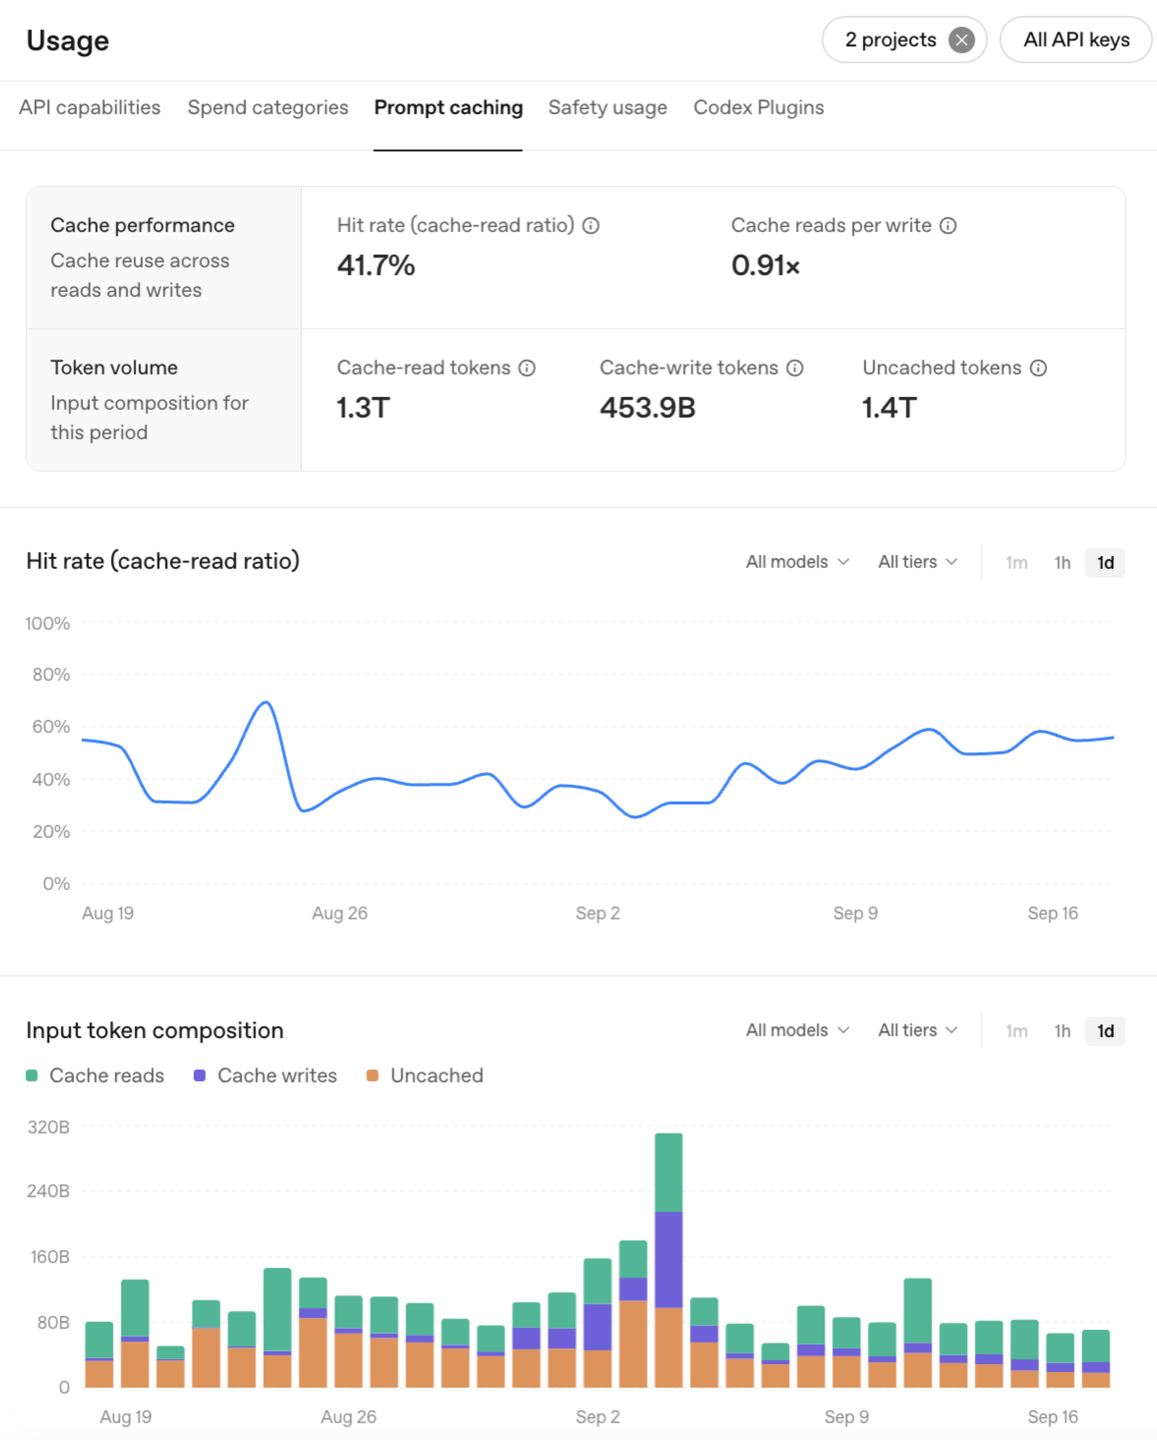
Na przykładowym koncie z ogłoszenia odsetek trafień z całego okresu wynosi 41,7 procent, a dolny wykres dzieli wejście na odczyty z cache, zapisy i tokeny liczone od zera.
Według GitHuba w ciągu kilku miesięcy odsetek tokenów, które Copilot musi przetwarzać od nowa, spadł o ponad połowę w skali miliardów zapytań do modeli OpenAI, a pierwsza część odpowiedzi przychodzi szybciej. Twórcy przeglądarki Strawberry podnieśli dzięki panelowi i diagnostyce odsetek trafień o kilka punktów procentowych, co obniżyło ich koszty o 20 procent.
Ile to kosztuje: rachunek na przykładzie
Stawki OpenAI za milion tokenów, w USD, dla zapytań do 272 tysięcy tokenów:
| Model | Wejście | Zapis do cache | Odczyt z cache | Wyjście |
|---|---|---|---|---|
| GPT-6 Astra | 10,00 | 12,50 | 1,00 | 50,00 |
| GPT-6 Sol | 2,00 | 2,50 | 0,20 | 10,00 |
| GPT-6 Luna | 0,10 | 0,125 | 0,01 | 0,50 |
Przykład: czat na stronie z promptem systemowym o długości 20 tysięcy tokenów. Sto osób zadaje po jednym pytaniu w nowej rozmowie, a między pytaniami mija mniej niż pół godziny. Liczę tylko koszt promptu systemowego, bez pytań i odpowiedzi.
| Model | Bez cache | Tryb domyślny, bez punktu podziału | Z punktem podziału |
|---|---|---|---|
| GPT-6 Astra | 20,00 USD | 25,00 USD | 2,23 USD |
| GPT-6 Sol | 4,00 USD | 5,00 USD | 0,45 USD |
| GPT-6 Luna | 0,20 USD | 0,25 USD | 0,02 USD |
Środkowa kolumna to pułapka opisana w dokumentacji OpenAI. W trybie domyślnym cache zapisuje się do końca ostatniej wiadomości użytkownika, razem z pytaniem. Następne zapytanie z innym pytaniem do niego nie pasuje, więc za każde płacisz stawkę zapisu, o 25 procent wyższą niż bez cache. Punkt podziału zaraz po stałym prompcie daje jeden zapis i 99 odczytów, a rachunek spada o prawie 89 procent. Gdy historia rozmowy rośnie, tryb domyślny radzi sobie sam. W Batch API wszystkie stawki, także za cache, są o połowę niższe.
Co zrobić, żeby skorzystać
- Stałe na początek, zmienne na koniec: instrukcje i materiały referencyjne na górze, data, godzina i dane użytkownika na samym dole. Jako przykład przyczyny chybienia dokumentacja podaje znacznik czasu w instrukcjach.
- Nie ruszaj listy narzędzi: wyłączaj je na czas zapytania, zamiast usuwać.
- Stały prompt i jedno pytanie: dodaj punkt podziału po stałej części.
Nie musisz tego pisać sam: OpenAI proponuje zlecić Codeksowi przegląd kodu, poprawki i pomiar efektu. Tokeny z cache nadal liczą się do limitu tokenów na minutę, czyli rate limitu.
Co to zmienia dla abonentów ChatGPT, Codeksa i Copilota
Ogłoszenie jest skierowane do deweloperów i nie wspomina o planach ChatGPT. Bezpośrednio dotyczy rachunku za API: własnych aplikacji, skryptów i narzędzi na własnym kluczu (BYOK). To samo dotyczy Codeksa używanego z kluczem API, bo wtedy płacisz według cennika API, razem z opłatą za zapis do cache.
W Codeksie na abonamencie cache wpływa na to, jak długo starcza limit, co OpenAI wymienia obok modelu, kontekstu i narzędzi. W cenniku kredytów Sol kosztuje 50 kredytów za milion tokenów wejścia, 5 za tokeny z cache i 250 za wyjście, a osobnej opłaty za zapis do cache nie ma. Już w listopadzie 2025 OpenAI przyznało, że kilka chybień cache z rzędu potrafiło wyraźnie skrócić dostępną pulę. Szacunki wiadomości w oknie pięciogodzinnym opisaliśmy przy premierze Sola i Luny. Żeby limit starczał dłużej, OpenAI radzi skracać plik AGENTS.md i wyłączać nieużywane serwery MCP.
Copilot liczy kredyty AI od tokenów, osobno za wejście, wyjście, odczyt z cache i zapis do cache, po stawkach modelu. Przy Solu odczyt kosztuje 0,20 USD za milion tokenów, a zapis 2,50 USD, więc więcej trafień oznacza mniej kredytów za tę samą pracę w czacie i trybie agenta. Podpowiedzi w edytorze nie zużywają kredytów.
Jak to wygląda u Anthropic i Google
U OpenAI cache działa bez włączania i przechowuje dane przez 30 minut. W API Anthropic trzeba go włączyć za pomocą pola cache_control, choć wystarczy jedno na całe zapytanie. Domyślnie przechowuje dane przez 5 minut, a ten czas odnawia się przy każdym użyciu. Wersja godzinna kosztuje przy zapisie dwukrotność stawki wejścia. Odczyt z cache w Claude Opus 5.5 kosztuje 0,20 USD za milion tokenów, tyle co w Solu. Google w modelach Gemini 2.5 i nowszych włącza cache domyślnie, a w Gemini od 3.5 do 3.8 Flash buforowany fragment musi mieć co najmniej 4096 tokenów.
Co to znaczy dla vibe codingu
Jeśli płacisz abonament, ogłoszenie nie wymaga od Ciebie żadnego kroku. Jeśli masz aplikację na API, otwórz panel Prompt Caching i sprawdź odsetek trafień, zanim zmienisz model na tańszy: przy stałym prompcie i pojedynczych pytaniach jeden punkt podziału obcina koszt tej części prawie dziewięciokrotnie. Jak łatwo przepalić budżet na tokenach, pisaliśmy przy firmowych limitach wydatków, a rachunek policzysz w kalkulatorze kosztów API.
Opanuj AI‑coding w 5 minut. W każdy poniedziałek.
Konkretne premiery, analizy cen i jeden trik, który przyspieszy Twoją pracę. Po polsku, bez żargonu, prosto na maila.