Gemini 2.5 Pro wycofany: co od 1 grudnia?
Google wycofał Gemini 2.5 Pro i 2.5 Flash z AI Studio. Od 1 grudnia zapytania do nich trafią do 3.8 Flash i 3.5 Flash-Lite. Sprawdź, co może się zepsuć.
Google 2 listopada wycofał modele gemini-2.5-pro i gemini-2.5-flash z Google AI Studio, czyli przeglądarkowego narzędzia Google do pracy z Gemini, więc nie wybierzesz ich już z listy modeli. Od 1 grudnia 2026 zapytania API do tych nazw będą automatycznie trafiać do nowszych modeli: z Gemini 2.5 Pro do Gemini 3.8 Flash, a z Gemini 2.5 Flash do Gemini 3.5 Flash-Lite. Zapłacisz według stawek nowych modeli. Jeśli Twoja apka z trybu Build w AI Studio albo narzędzie z własnym kluczem Gemini używa jednej z tych nazw, 1 grudnia zacznie korzystać z innego modelu, a często zmienią się też koszt i sposób działania, bez żadnego kliknięcia z Twojej strony.
Co dokładnie dzieje się 1 grudnia
Google nie wyłącza starych nazw, tylko podmienia model, który za nimi stoi. Apka nie dostanie więc komunikatu, że model zniknął: odpowiedzi zacznie po prostu pisać inny model językowy. Google robi tak nie pierwszy raz, bo zapytania do gemini-3.5-flash trafiają już do gemini-3.6-flash, a do gemini-3.7-flash do gemini-3.8-flash.
Obaj następcy stoją półkę niżej w ofercie Google: Pro trafia do linii Flash, a Flash do tańszej Flash-Lite. Google zapewnia, że 3.5 Flash-Lite i tak wypada lepiej od 2.5 Flash, na przykład w teście rozumowania HLE (18,0 wobec 11,0 procent), ale to wynik producenta. Z modeli 2.5 przez API korzystają dziś tylko ich dotychczasowi aktywni użytkownicy, a Gemini 2.5 Flash-Lite nie jest wycofany.
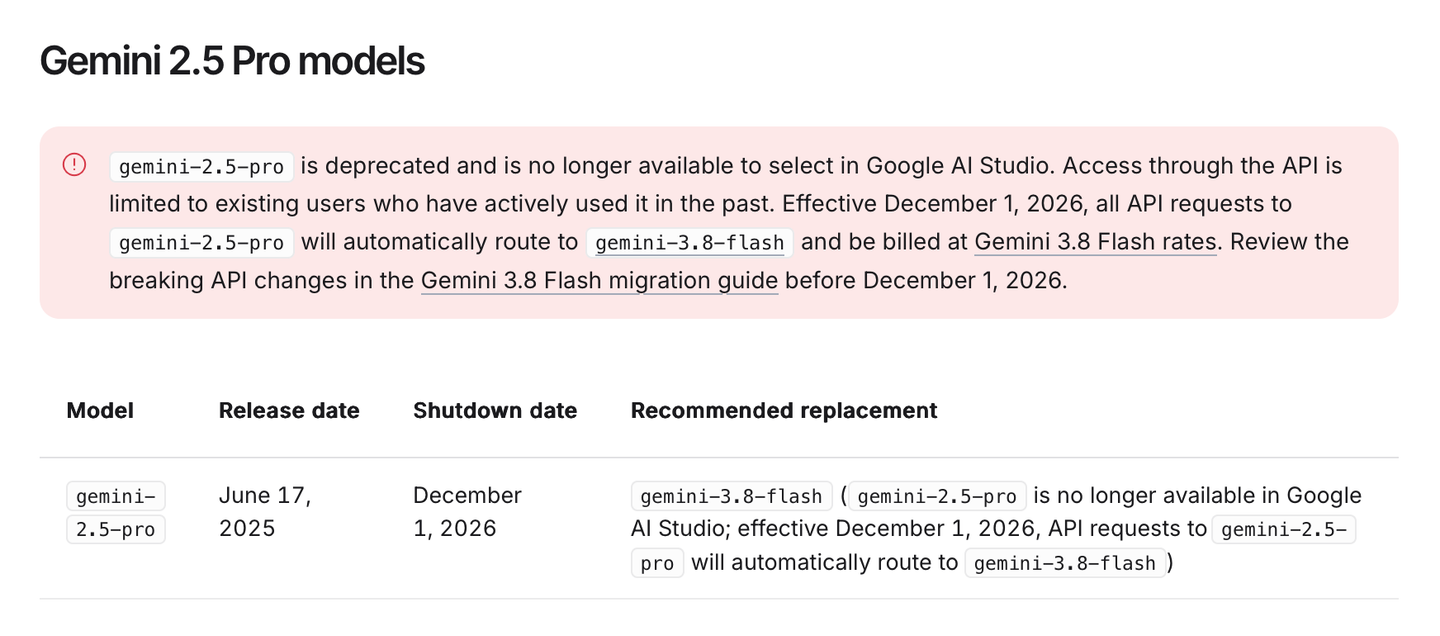
Notka o 2.5 Flash w dokumentacji brzmi podobnie, tylko jako następcę wskazuje 3.5 Flash-Lite.
Ile zapłacisz po przekierowaniu
Ceny w USD za milion tokenów na płatnym poziomie API, według cennika Google:
| Model | Wejście | Wyjście |
|---|---|---|
| 2.5 Pro, zapytanie do 200 tys. tokenów | 1,25 | 10,00 |
| 2.5 Pro, zapytanie powyżej 200 tys. | 2,50 | 15,00 |
| 3.8 Flash do 31 grudnia 2026 | 0,75 | 3,75 |
| 3.8 Flash od 1 stycznia 2027 | 1,50 | 7,50 |
| 2.5 Flash (tekst, obraz, wideo) | 0,30 | 2,50 |
| 3.5 Flash-Lite | 0,30 | 2,50 |
Przy 2.5 Flash stawki za tekst się nie zmieniają, a nagrania audio wysyłane do modelu tanieją z 1,00 do 0,30 USD. Przy 2.5 Pro w grudniu obie stawki spadną, bo 3.8 Flash działa w cenie wprowadzającej. Od stycznia wejście zdrożeje do 1,50 USD, powyżej 1,25 USD, które 2.5 Pro bierze za zapytania do 200 tys. tokenów, a wyjście stanieje z 10 do 7,50 USD. Przy takich zapytaniach 3.8 Flash wyjdzie więc drożej tylko wtedy, gdy apka wysyła ponad dziesięć razy więcej tokenów, niż dostaje z powrotem, na przykład analizując długie dokumenty.
Stawka to jednak nie wszystko. Google pisze, że 3.8 Flash z założenia może zużywać więcej tokenów przy długich, złożonych zadaniach, bo rozumuje mniejszymi krokami i sprawdza swoją pracę, a tokeny myślenia liczą się jak wyjście. Po zmianie zajrzyj do panelu zużycia w AI Studio albo policz scenariusz w kalkulatorze kosztów API.
Na darmowym poziomie API nie płacisz za tokeny w żadnym z czterech modeli. Wyjątek: 2.5 Flash daje tam do 500 darmowych zapytań dziennie z wyszukiwaniem Google, a w cenniku 3.5 Flash-Lite ta funkcja na darmowym poziomie jest niedostępna, poza testami w AI Studio.
Co może się zepsuć
Google ostrzega, że część zmian w API może zepsuć działający kod. Po ludzku:
- Ustawienia losowości przestają działać: nowe modele ignorują
temperature,top_pitop_k, więc niska temperatura, która ograniczała losowość, nie da już powtarzalnych odpowiedzi (więcej przy wygaszaniu parametru temperature). - Nie podasz już modelowi początku odpowiedzi: zapytanie zakończone wpisanym z góry fragmentem odpowiedzi modelu (popularny sposób na wymuszenie formatu JSON) API odrzuci z błędem 400.
- Inaczej ustawia się myślenie: zamiast liczbowego
thinking_budgetwybiera się nazwany poziomthinking_level. 3.8 Flash zwraca błąd na poziomieminimal, a 3.5 Flash-Lite działa na nim domyślnie, choć przy pracy z narzędziami Google zalecamediumalbohigh. - Wywołania narzędzi (function calling): gdy model uruchamia funkcje Twojej aplikacji, odpowiedź narzędzia musi mieć identyfikator i nazwę z wywołania. W starszym interfejsie
generateContentniezgodność zwykle daje pustą odpowiedź zamiast błędu, czyli awarię bez żadnego komunikatu.
Jak przygotować apkę przed 1 grudnia
- Znajdź nazwę modelu: w trybie Build otwórz zakładkę Code w panelu podglądu i poszukaj tekstu
gemini-2.5. W narzędziach z własnym kluczem (BYOK) nazwa jest wpisana w ustawieniach integracji albo automatyzacji. Wpisgemini-2.5-flash-litezostaw. - Zmień nazwę modelu:
gemini-2.5-pronagemini-3.8-flash, agemini-2.5-flashnagemini-3.5-flash-lite. W Build wystarczy poprosić agenta w czacie o zmianę modelu, a Google podsuwa też migrację agentem z umiejętnością gemini-api-dev, na przykład w Antigravity. - Przetestuj przed terminem: usuń temperaturę, podpowiadane odpowiedzi i stary budżet myślenia, potem sprawdź ścieżki z narzędziami, odpowiedzi w JSON-ie i dłuższe rozmowy.
Co z abonamentem Google AI Pro i Ultra
Abonament nie pokrywa rachunku za apkę. Według Google korzyści z planów Google AI dla twórców obejmują tylko AI Studio w przeglądarce, a użycie Gemini API przez klucze i zewnętrzne aplikacje rozlicza się osobno. Aplikacja na własnym kluczu API zapłaci więc po 1 grudnia stawki z tabeli, niezależnie od tego, czy masz plan Pro, czy Ultra. Abonenci, którzy mają projekt w Google Cloud z włączonymi płatnościami, mogą jednak dostawać miesięczne kredyty z Google Developer Program, które obejmują też Gemini API.
Dzienne limity planu w AI Studio odnawiają się raz na dobę, a nie w ruchomym oknie czasu. W API dzienne limity zapytań resetują się o północy czasu pacyficznego, czyli zimą o 9:00 w Polsce. Limity zależą od modelu, więc po zmianie nazwy sprawdź je na stronie limitów w AI Studio.
Opanuj AI‑coding w 5 minut. W każdy poniedziałek.
Konkretne premiery, analizy cen i jeden trik, który przyspieszy Twoją pracę. Po polsku, bez żargonu, prosto na maila.