Grok 4.7: prawie jak Opus 5, za połowę kosztu zadania
SpaceXAI wydało Grok 4.7: cena bez zmian, w CursorBench wynik Opusa 5 za połowę kosztu zadania. Co to znaczy w Cursorze, Copilocie i SuperGrok.
SpaceXAI, czyli dawne xAI, wydało w poniedziałek 21 września Grok 4.7, swój najmocniejszy model do kodowania. Cena się nie zmienia: 2 USD za milion tokenów na wejściu i 6 USD na wyjściu, tyle samo co u Groka 4.6 z sierpnia. Według danych xAI w teście CursorBench 4.0 nowy Grok rozwiązuje 46,3 procent zadań, a Claude Opus 5 w najwyższym trybie 46,6 procent. Średni koszt zadania wynosi odpowiednio 6,01 i 11,95 USD. Niezależne pomiary Artificial Analysis stawiają go jednak na 21. miejscu i pokazują, że jest wyraźnie wolny. Z abonamentem skorzystasz z niego w Cursorze, Grok Build i GitHub Copilot, ale jeszcze nie w czacie Groka.
Cennik bez zmian i wariant Fast
W API model nazywa się grok-4.7 i ma okno kontekstu na 500 tysięcy tokenów. Powyżej 200 tysięcy tokenów w zapytaniu stawki rosną dwukrotnie. Do wyboru są cztery poziomy wysiłku, które decydują, jak długo model myśli nad zadaniem: low, medium, high (domyślny) i xhigh. Jest też wariant Fast: ten sam model na szybszych serwerach, dwa razy szybszy i dwa razy droższy, dostępny tylko w Cursorze i Grok Build.
Skok względem Groka 4.6 (dane xAI)
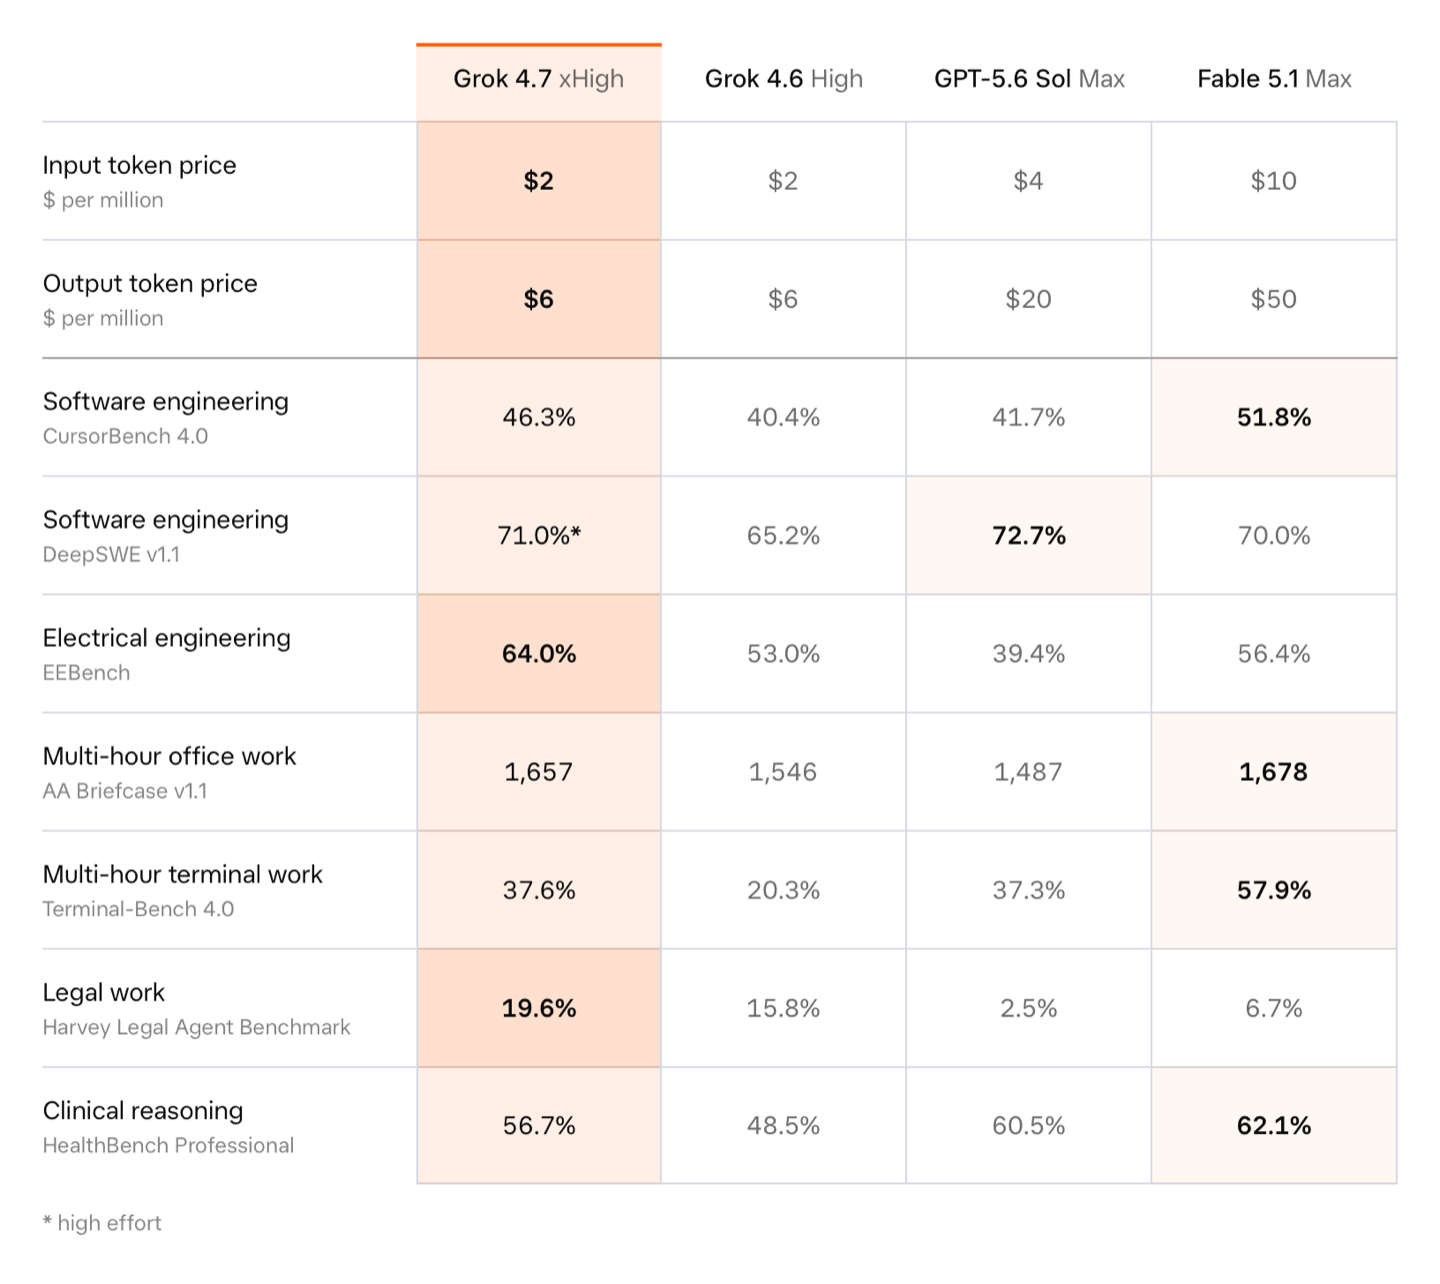
Przy tej samej cenie Grok 4.7 wypadł lepiej niż poprzednik we wszystkich siedmiu testach, ale w czterech z nich wyprzedza go Fable 5.1.
Najbardziej urósł wynik w Terminal-Bench 4.0, który sprawdza wielogodzinną pracę agenta w terminalu: z 20,3 do 37,6 procent, czyli praktycznie tyle co GPT-5.6 Sol (37,3), choć Claude Fable 5.1 ma 57,9 procent.
Przy CursorBench warto znać kontekst. Cursor buduje ten test z prawdziwych sesji w swoim edytorze, od 14 sierpnia należy do SpaceX, a według karty modelu Grok 4.7 był dodatkowo trenowany na zanonimizowanych danych z pracy w Cursorze. Przy Groku 4.5 Cursor sam przyznał, że wyciek danych do treningu zawyżył wynik w starszej wersji testu. To nie przekreśla liczb, ale każe czytać je ostrożniej niż niezależne benchmarki.
Koszt zadania zamiast ceny za token
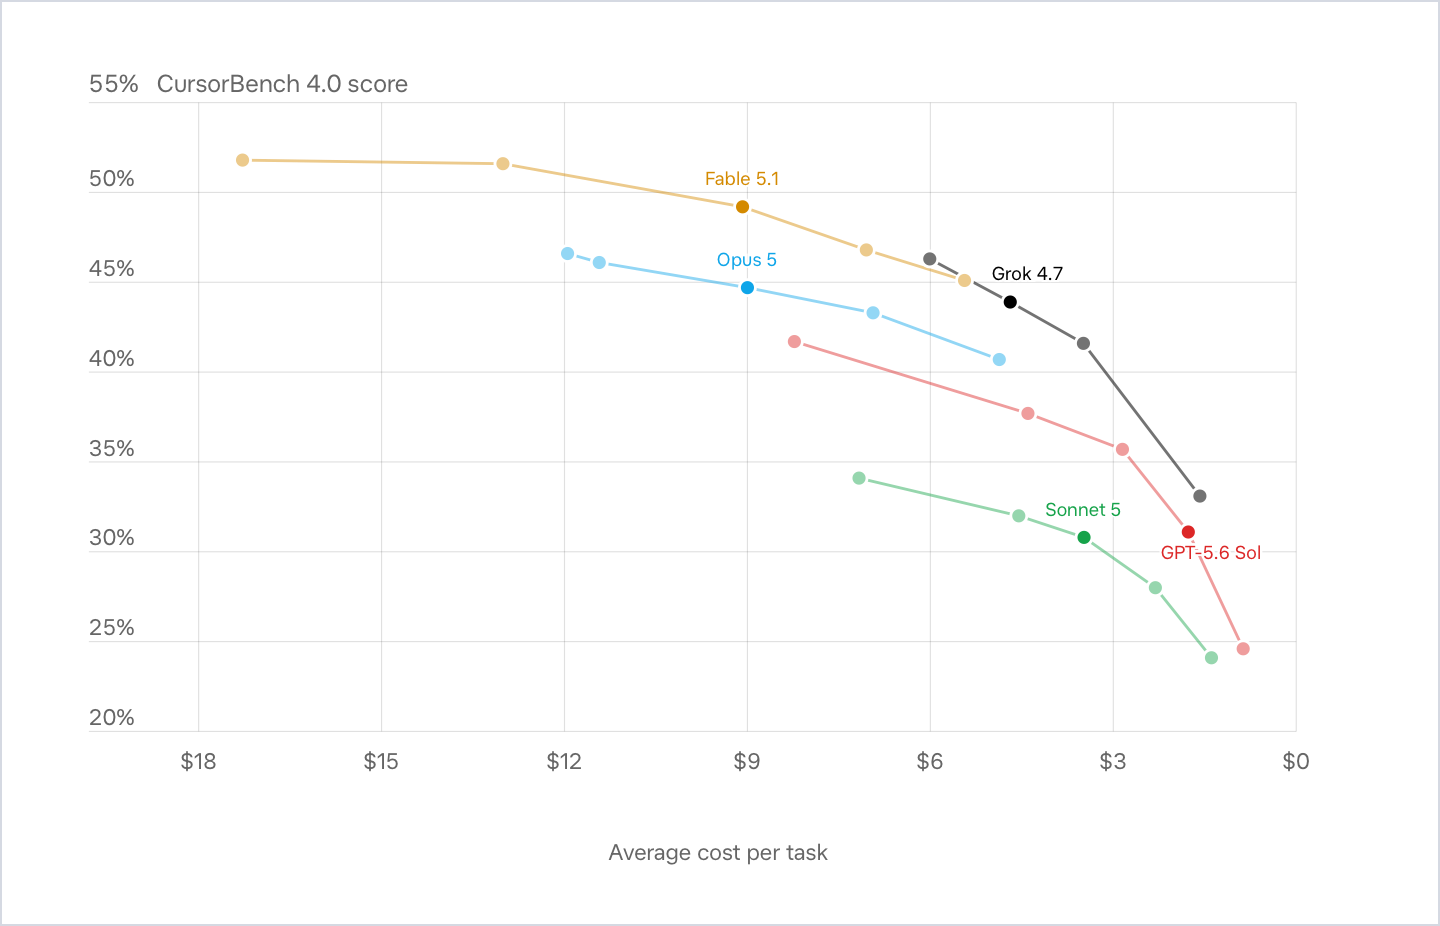
Przy tym samym koszcie zadania Grok 4.7 wypada lepiej od Opusa 5, GPT-5.6 Sol i Sonneta 5, a mniej więcej tak samo jak Fable 5.1 na najtańszych ustawieniach.
Cena za milion tokenów nie mówi tu wszystkiego. Fable 5.1 kosztuje w cenniku 10 i 50 USD, a na niskim poziomie wysiłku rozwiązuje 45,1 procent zadań za 5,44 USD, czyli niewiele mniej niż Grok 4.7 na xhigh, a taniej.
Co mówią niezależne pomiary
Artificial Analysis daje Grokowi 4.7 w trybie xhigh 46 punktów w indeksie inteligencji, czyli 21. miejsce na 212 modeli. Wydany dzień później Claude Opus 5.5 ma 58 punktów, Fable 5.1 53, a GPT-6 Sol 48.
xAI reklamuje model jako „dwa razy szybszy, za połowę ceny porównywalnych modeli”. Artificial Analysis mierzy w API 39,3 tokenu na sekundę przy medianie 74,7 dla modeli z tej półki cenowej. Podczas testów do indeksu Grok wygenerował też 240 milionów tokenów na wyjściu wobec mediany 88 milionów. Mimo to jedno zadanie z indeksu kosztuje u niego średnio 3,74 USD, mniej niż u Opusa 5.5 (5,98 USD), ale więcej niż u GPT-6 Astry (3,26 USD), która ma w indeksie 53 punkty.
Co z abonamentami
- SuperGrok i Premium w X: w czacie Groka, na grok.com i w Groku w serwisie X nowego modelu jeszcze nie ma. Według karty modelu SpaceXAI doda go tam później. Abonent SuperGrok może z niego korzystać już teraz w Grok Build, a zużycie odlicza się od tygodniowej puli, wspólnej dla wszystkich produktów Groka. Długie zadanie z kodem zjada jej więcej niż wiadomość w czacie.
- Grok Build: Grok 4.7 jest domyślnym modelem tego agenta w terminalu i działa także w darmowym planie. Wariant Fast nie jest dostępny w darmowym planie, a jego stawki wynoszą 4 i 12 USD za milion tokenów.
- Cursor: model jest w każdym płatnym planie, od Pro za 20 USD miesięcznie. W darmowym planie Hobby nie wybierzesz modelu, działa tylko tryb Auto. Grok 4.7 korzysta z osobnej puli Cursor Models, niezależnej od puli na modele innych firm i odnawianą co miesiąc. Od planu Pro tryb Fast jest domyślnie włączony i kosztuje dwa razy więcej, a Cursor zaznacza, że wybór modelu decyduje o tempie zużycia puli. Poziom wysiłku i tryb Fast ustawiasz sam.
- GitHub Copilot: od planu Pro wzwyż, a w darmowym planie Copilot dobiera model automatycznie. Copilot liczy Groka 4.7 w kredytach AI po cenniku xAI, czyli 2 i 6 USD za milion tokenów. Pro za 10 USD daje 1500 kredytów miesięcznie, czyli 15 USD na tokeny, a Pro+ 7000. Kredyty odnawiają się pierwszego dnia miesiąca, a GitHub udostępnia model stopniowo.
Cursor potwierdza dostępność Groka 4.7 także w UE, a ogłoszenie xAI nie wyklucza Europy, choć przy Groku 4.5 poślizg trwał osiem dni. W API xAI gwarantuje miejsce przetwarzania danych tylko w regionie USA, za dopłatą 10 procent.
Co to znaczy dla vibe codingu
W Cursorze Pro Grok 4.7 jest rozliczany tak samo jak Grok 4.6, więc przesiadka nie podnosi kosztów. Sprawdź tylko, czy pracujesz w domyślnym trybie Fast, bo kosztuje dwa razy więcej i szybciej zużywa pulę. Warto też obniżyć poziom wysiłku: według danych xAI medium i high dają w CursorBench odpowiednio 41,6 i 43,9 procent za 3,49 i 4,69 USD na zadanie, a xhigh podnosi wynik do 46,3 procent kosztem 6,01 USD i dłuższego czekania. Z SuperGrok nowy model sprawdzisz dziś tylko w Grok Build.
W niezależnym indeksie Grok 4.7 ustępuje najnowszym modelom Anthropic i OpenAI. SpaceXAI zastrzega też w karcie modelu, że nie jest on przeznaczony do samodzielnego podejmowania decyzji w medycynie, prawie czy finansach bez nadzoru człowieka. Jeśli płacisz za API, koszt przy swojej skali przeliczysz w kalkulatorze kosztów API.
Opanuj AI‑coding w 5 minut. W każdy poniedziałek.
Konkretne premiery, analizy cen i jeden trik, który przyspieszy Twoją pracę. Po polsku, bez żargonu, prosto na maila.